이 글은 경량화 시리즈에서 앞으로 다룰 LLM 최적화 편을 위한 배경지식 편입니다. 지금까지 시리즈에서는 데이터타입, 양자화, 프루닝, 지식 증류처럼 모델을 작고 빠르게 만드는 일반적인 기법을 다뤘습니다. LLM을 최적화하려면 먼저 LLM이 안에서 무엇을 계산하는지, 그리고 어디서 메모리와 시간이 드는지를 알아야 합니다. 어텐션, KV 캐시, GQA, MoE처럼 LLM 최적화 편에서 계속 나올 개념들을 여기서 먼저 쌓아 두겠습니다.
LLM은 이미 곳곳에 있다
ChatGPT 같은 대화형 서비스, 구글 번역, GitHub Copilot 같은 코드 자동완성, 사진을 보고 설명해 주는 비서까지. 겉모습은 다르지만 안쪽은 모두 트랜스포머(Transformer) 라는 같은 구조 위에 서 있습니다.
이 글은 네 가지 질문을 순서대로 따라갑니다.
- 트랜스포머는 문장을 어떻게 이해하는가
- 그 뒤로 어떤 개선이 붙었는가
- 크게 키우니 무엇이 달라졌는가
- 글자만 읽던 모델이 어떻게 이미지를 보게 되었는가
그 전에, 트랜스포머가 왜 필요했는지부터 보겠습니다.
트랜스포머 이전 시절
언어 문제의 두 종류
자연어 처리(NLP) 문제는 크게 두 갈래입니다.
- 판별(discriminative): 문장을 읽고 답을 고릅니다. “이 영화 리뷰는 긍정인가 부정인가”, “이 메일은 스팸인가” 같은 문제입니다.
- 생성(generative): 문장을 이어서 만들어 냅니다. 다음 단어 예측, 번역, 요약이 여기에 속합니다.
예를 들어 “As a visual treat, the film is almost perfect.” 라는 문장을 주고 긍정/부정을 고르면 판별이고, “the film is almost” 뒤에 “perfect"를 채워 넣으면 생성입니다.
RNN: 한 단어씩 읽으며 기억을 갱신한다
트랜스포머 이전의 주력은 RNN(Recurrent Neural Network) 과 그 개량형인 LSTM 이었습니다. 사람이 글을 읽듯 단어를 하나씩 순서대로 읽으면서, 지금까지 읽은 내용을 “작업 기억(hidden state)” 하나에 계속 덮어써 가는 방식입니다.
판별 문제에는 문장을 앞뒤 양방향으로 읽는 RNN을, 생성 문제에는 앞에서 뒤로만 읽는 RNN을 썼습니다. 번역처럼 입력과 출력이 모두 문장인 경우에는 RNN 두 개를 이어 붙인 seq2seq 구조를 썼고, 2014년에는 여기에 어텐션(attention) 을 보조 장치로 붙이는 방법도 나왔습니다(Bahdanau et al., 2014). 어텐션이라는 아이디어 자체는 트랜스포머보다 먼저 있었던 셈입니다.
RNN에는 근본적인 한계가 두 가지 있었습니다.
첫째, 멀리 떨어진 단어 관계를 잘 기억하지 못합니다. “The chef who … was” 라는 문장에서 “was"의 주어는 한참 앞의 “chef"입니다. RNN에서는 “chef"의 정보가 중간 단어 수만큼 단계를 거쳐 전달되고, 그 사이에 정보가 희미해집니다. 이미지는 가까운 픽셀끼리 관련이 깊지만(국소성), 언어는 멀리 떨어진 단어끼리 강하게 연결되는 경우가 많아서 이 문제가 특히 아픕니다.
둘째, 병렬로 학습할 수 없습니다. n번째 단어의 상태를 계산하려면 앞의 n-1개 상태가 먼저 계산되어 있어야 합니다. GPU는 수천 개의 계산을 동시에 하는 데 강한데, RNN은 구조상 줄을 서서 하나씩 계산해야 합니다. 데이터와 모델을 키우기가 어려웠던 이유입니다.
CNN: 병렬은 되지만 시야가 좁다
이미지에서 성공한 CNN(합성곱 신경망) 을 텍스트에 쓰는 시도도 있었습니다. CNN은 단어 간 순서 의존이 없어서 병렬 계산이 잘 됩니다. 대신 한 번에 보는 범위(커널 크기)가 몇 단어로 제한되어, 문장 전체의 맥락을 담으려면 층을 아주 깊게 쌓아야 했습니다.
정리하면 RNN은 맥락은 보지만 느리고, CNN은 빠르지만 맥락이 좁았습니다. 여기서 자연스러운 질문이 나옵니다. “모든 단어가 모든 단어를 한 번에 볼 수 있으면 어떨까?” 이 질문에 대한 답이 2017년 구글의 논문 “Attention Is All You Need"에서 나온 트랜스포머입니다. 제목 그대로, RNN 없이 어텐션만으로 충분하다는 주장이었습니다.
1부. 트랜스포머 기초
전체 그림
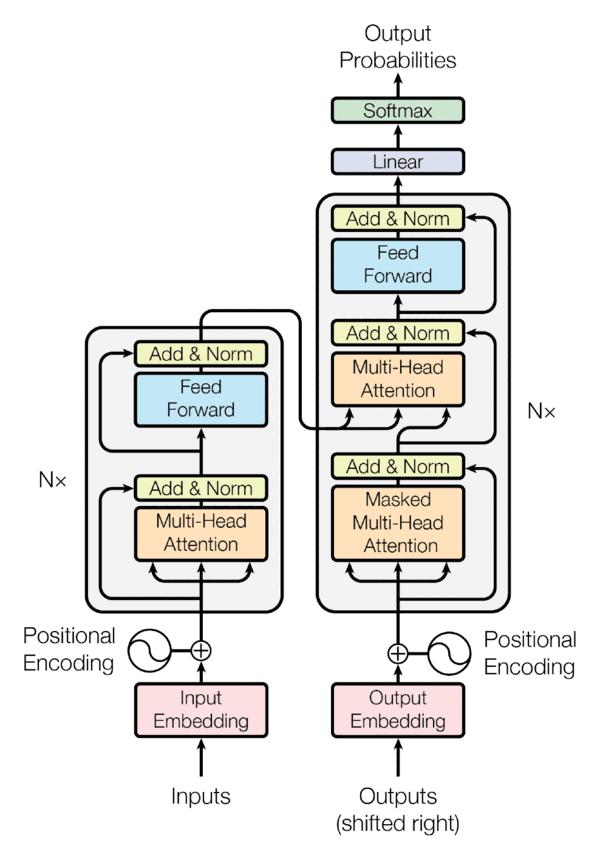
출처: Vaswani et al., Attention Is All You Need, NeurIPS 2017, Figure 1
트랜스포머가 문장을 처리하는 흐름은 다음과 같습니다.
- 토큰화: 문장을 토큰이라는 조각으로 자릅니다.
- 임베딩: 각 토큰을 숫자 벡터로 바꿉니다.
- 위치 인코딩: 각 토큰이 몇 번째인지 정보를 더합니다.
- 트랜스포머 블록 반복: 어텐션과 FFN으로 이루어진 블록을 수십 번 통과하며 표현을 다듬습니다.
- 출력: 마지막 벡터로 다음 토큰의 확률을 계산합니다.
하나씩 보겠습니다.
토큰화: 모델이 읽는 단위
모델은 글자나 단어를 그대로 읽지 않습니다. 토크나이저(tokenizer) 가 문장을 미리 정해 둔 사전(vocabulary) 속 조각, 즉 토큰(token) 으로 자르고, 각 토큰을 사전 안의 번호(토큰 ID)로 바꿉니다. 모델이 실제로 받는 입력은 글자가 아니라 이 번호 목록입니다.
실제 LLM의 사전에는 토큰이 수만에서 수십만 개 있습니다. 여기서는 원리만 보기 위해 토큰 11개짜리 장난감 사전을 쓰겠습니다. 단어 8개와 마침표, 그리고 특수 토큰 <s>, <unk> 두 개입니다. 이어지는 1부의 위젯들도 모두 이 사전과 예문을 함께 씁니다.
위젯에서 볼 점은 네 가지입니다.
- 시작 토큰: 문장 맨 앞에
<s>가 붙습니다. 모델에게 “여기서부터 문장이 시작된다"고 알려 주는 표시입니다. - 마침표도 토큰: 단어만 토큰이 되는 것이 아닙니다. 마침표, 쉼표, 공백 같은 것도 사전에 있으면 하나의 토큰입니다.
- 같은 단어는 같은 ID: “the dog bites the man.“에서
the는 두 번 모두 ID 2가 됩니다. 모델 입장에서 두the는 완전히 같은 입력입니다. 이 점은 뒤에서 위치 정보가 왜 필요한지 설명할 때 다시 나옵니다. - 사전에 없는 단어: 프리셋의 “the dog eats a bone.“을 눌러 보세요.
a와bone은 사전에 없어서 둘 다<unk>(unknown, ID 1) 로 바뀝니다. 모델 입장에서는a와bone이 같은 토큰이 되어 버려, 무슨 단어였는지 알 수 없습니다.
<unk>가 많아지면 정보가 사라지므로, 실제 토크나이저는 사전에 없는 단어를 더 작은 조각으로 쪼개서 <unk>가 거의 나오지 않게 만듭니다. 자주 나오는 단어는 통째로 토큰 하나가 되고, 드문 단어는 “un” + “believ” + “able"처럼 여러 조각으로 나뉩니다. 최근 토크나이저는 바이트 단위까지 내려가서 어떤 글자든 표현할 수 있습니다.
실무에서 토큰이 중요한 이유도 여기서 나옵니다.
- 비용: LLM API는 입력과 출력의 토큰 수로 과금합니다.
- 길이 제한: “컨텍스트 128K"는 토큰 12만 8천 개까지 넣을 수 있다는 뜻입니다.
- 언어별 차이: 사전이 영어 위주로 만들어지면 한국어 같은 언어는 같은 내용에 토큰이 더 많이 듭니다. 최근 모델들은 사전을 키워 이 차이를 많이 줄였지만, 모델마다 효율이 다르니 직접 세어 보는 것이 좋습니다.
임베딩: 토큰을 숫자 벡터로
토큰 ID는 그냥 번호입니다. dog가 3이고 cat이 4라고 해서 둘이 비슷하다는 뜻은 아닙니다. 모델이 계산을 하려면 각 토큰을 의미를 담은 숫자 벡터로 바꿔야 합니다.
가장 단순한 방법은 원핫 인코딩(one-hot encoding) 입니다. 사전 크기만큼 긴 벡터를 만들고 자기 자리에만 1을 둡니다. 우리 사전이라면 dog는 11칸 중 3번 칸만 1인 벡터입니다. 하지만 두 가지 문제가 있습니다.
- 너무 깁니다. 실제 사전은 토큰이 수만에서 수십만 개라서 벡터도 그만큼 길고, 거의 전부가 0입니다.
- 모든 단어가 서로 똑같이 멉니다. 서로 다른 두 원핫 벡터의 내적은 항상 0입니다. “dog와 cat은 비슷하고 dog와 eats는 다르다"는 정보를 담을 수 없습니다.
그래서 임베딩(embedding) 을 씁니다. 토큰마다 짧은 실수 벡터를 하나씩 배정한 임베딩 표를 두고, 토큰 ID에 해당하는 행을 꺼내 쓰는 것이 전부입니다. 표에서 행을 찾아 꺼낸다고 해서 룩업(look-up)이라고 부릅니다. 여기서는 벡터를 4차원으로 잡았고, 실제 LLM은 수천 차원을 씁니다. Llama 2 7B는 4,096차원입니다.
위젯에서 볼 점은 네 가지입니다.
- 문장은 행렬이 됩니다. 토큰 7개짜리 문장은 7×4 행렬이 됩니다. 여기에 다음 단계의 위치 정보를 더한 것이 트랜스포머 블록의 입력이 됩니다.
- 같은 토큰은 같은 행입니다. “the dog bites the man.“에서
the는 두 번 모두 똑같은 벡터입니다. 지금까지는 몇 번째 자리인지에 대한 정보가 어디에도 없습니다. 이 문제는 바로 다음의 위치 인코딩에서 다룹니다. - 비슷한 자리에 쓰이는 토큰은 가깝습니다. dog, cat, man은 모두 “the _ bites"의 빈칸에 들어갈 수 있어서 벡터도 서로 비슷합니다. bites와 chases도 마찬가지입니다. 두 벡터가 얼마나 비슷한지는 코사인 유사도로 잽니다. 방향이 같으면 1, 직각이면 0, 반대면 -1입니다. 원핫 벡터였다면 서로 다른 토큰끼리는 언제나 0입니다.
- 이 값은 사람이 정하지 않습니다. 위젯의 값은 설명을 위해 직접 정했지만, 실제 모델에서 임베딩 표는 처음에 무작위로 시작합니다. 다음 토큰을 잘 맞추도록 학습하는 과정에서, 비슷하게 쓰이는 토큰끼리 자연스럽게 가까워집니다. 그래서 실제 모델의 각 차원에는 사람이 이름 붙일 수 있는 뜻이 없는 경우가 대부분입니다.
이 아이디어는 2013년 Word2Vec이 널리 알렸고, 지금의 LLM은 임베딩 표를 모델 전체와 함께 처음부터 학습합니다.
위치 인코딩: 순서 정보 넣기
임베딩까지 마친 행렬에는 큰 빈틈이 있습니다. 토큰이 몇 번째 자리에 있는지에 대한 정보가 없습니다. RNN은 단어를 순서대로 하나씩 읽었기 때문에 순서가 저절로 반영되었지만, 트랜스포머는 모든 토큰을 한꺼번에 처리합니다. “the dog bites the man.“과 “the man bites the dog.“는 같은 행들을 순서만 바꿔 쌓은 행렬이 되고, 뒤에서 볼 어텐션만으로는 이 차이를 알아챌 수 없습니다. 개가 사람을 물었는지 사람이 개를 물었는지가 사라지는 셈입니다.
해결책은 단순합니다. 위치마다 고유한 벡터를 하나씩 정해 두고 토큰 임베딩에 더합니다. 원래 트랜스포머는 위치 t마다 주기가 서로 다른 사인과 코사인 값으로 이 벡터를 만들었습니다. d는 벡터 차원이고 k는 차원 쌍의 번호입니다.
$$PE(t, 2k) = \sin\left(\frac{t}{10000^{2k/d}}\right), \qquad PE(t, 2k+1) = \cos\left(\frac{t}{10000^{2k/d}}\right)$$앞쪽 차원은 위치에 따라 빠르게, 뒤쪽 차원은 천천히 변합니다. 시계의 초침과 분침처럼 속도가 다른 바늘을 조합해서 위치마다 다른 패턴을 만드는 방식입니다. 위젯은 4차원뿐이라 10000 대신 100을 써서 뒤쪽 차원의 변화도 눈에 보이게 했습니다.
위젯에서 볼 점은 세 가지입니다.
- 같은 토큰도 자리가 다르면 달라집니다. 점선으로 표시된 두
the행은 임베딩에서는 똑같지만, 위치 인코딩을 더한 결과는 서로 다릅니다. - 순서를 바꾸면 결과가 바뀝니다. “the dog bites the man.“과 “the man bites the dog.“를 번갈아 눌러 보세요. 임베딩에서는 dog와 man 행이 자리만 바꾸지만, 합에서는 두 행의 값 자체가 달라집니다.
- 위치 인코딩은 문장 내용과 상관없습니다. 가운데 히트맵은 어떤 문장을 넣어도 같은 위치에서는 같은 값이고, 문장 길이만큼만 늘어납니다.
이렇게 위치 번호를 벡터로 만들어 더하는 방식을 절대 위치 인코딩이라고 합니다. 원래 트랜스포머가 쓴 방식이고, 지금의 LLM은 대부분 2부에서 볼 RoPE 같은 상대 위치 방식을 씁니다. 위젯의 세 번째 히트맵인 합이 트랜스포머 블록에 실제로 들어가는 입력입니다.
셀프 어텐션: 트랜스포머의 핵심
이제 트랜스포머 블록 안으로 들어갑니다. 블록의 첫 부품인 셀프 어텐션(self-attention) 은 각 토큰이 “나를 이해하려면 문장의 어느 토큰을 봐야 하는가” 를 스스로 계산하는 장치입니다.
비유로 시작하겠습니다. 유튜브에서 검색할 때를 떠올려 보세요.
- Query(질의): 검색창에 입력한 검색어
- Key(키): 각 영상의 제목과 설명
- Value(값): 실제 영상 내용
검색어와 제목이 얼마나 맞는지 점수를 매기고, 점수가 높은 영상을 보여 줍니다. 셀프 어텐션도 같습니다. 각 토큰의 입력 벡터에 서로 다른 가중치 행렬 세 개를 곱해 세 가지 버전을 만듭니다. “나는 이런 정보를 찾고 있다"는 Query, “나는 이런 정보를 갖고 있다"는 Key, “나를 참고하면 이 내용을 가져가라"는 Value입니다.
계산은 세 단계입니다.
- 각 토큰의 Query를 모든 토큰의 Key와 내적해서 점수를 매깁니다. 토큰이 N개면 N×N 점수표가 나옵니다.
- 점수를 행마다 softmax로 바꿔서 합이 1인 가중치로 만듭니다.
- 이 가중치로 모든 토큰의 Value를 가중 평균한 것이 그 토큰의 출력입니다.
수식으로 쓰면 다음과 같습니다. $d$는 벡터 차원이고, $\sqrt{d}$로 나누는 것은 차원이 클 때 점수가 너무 커져 softmax가 한 토큰에만 쏠리는 것을 막기 위해서입니다.
$$\mathrm{Attention}(Q, K, V) = \mathrm{softmax}\left(\frac{QK^\top}{\sqrt{d}}\right)V$$아래 위젯은 위치 인코딩까지 더한 입력에서 출발해 이 계산을 끝까지 펼쳐 보여 줍니다. 점수 표의 칸을 누르면, 그 값이 어느 Query 행과 어느 Key 행을 곱해서 나왔는지 위쪽에 표시되고 계산식이 풀려 나옵니다. 세 가중치 행렬은 실제 모델에서는 학습으로 정해지고, 여기서는 설명을 위해 맞춘 값을 썼습니다.
위젯에서 볼 점은 다섯 가지입니다.
- 가중치는 “어디서 얼마나 가져올지"입니다. 가중치 표에서
bites행을 누르면, 출력이 가중치가 큰 토큰의 Value를 그만큼 많이 섞어 만들어지는 것이 보입니다. 이 위젯에서는 설명을 위해bites가dog를 가장 많이 보도록 가중치 행렬을 맞춰 두었습니다. 실제 모델의 패턴은 학습으로 정해지고, 이렇게 깔끔한 문법 관계로 떨어지지 않는 경우가 대부분입니다. - 위치 정보가 점수에 들어갑니다. “the man bites the dog.“를 누르면 같은 단어들인데도 점수표가 달라집니다. 앞 단계에서 더한 위치 인코딩이 Query와 Key에 들어가 있기 때문입니다.
- 모든 토큰이 모든 토큰을 한 번에 봅니다. RNN이라면 앞에서부터 차례로 전달해야 했던 정보를, 어텐션은 거리에 상관없이 한 단계 만에 가져옵니다. 각 행의 계산은 서로 독립이라 GPU에서 한꺼번에 처리할 수 있습니다. 앞에서 본 RNN의 두 가지 한계를 동시에 해결한 셈입니다.
- 입력과 출력의 크기가 같습니다. 입력 X가 7×4였고 출력도 7×4입니다. 토큰마다 벡터 하나가 들어가서, 문장 전체의 정보를 섞은 벡터 하나가 나옵니다. 이 점을 꼭 기억해 두세요. 크기가 같기 때문에 뒤에서 볼 잔차 연결로 입력에 출력을 그대로 더할 수 있고, 같은 블록을 수십 번 쌓을 수 있습니다.
- 대가는 N×N 점수표입니다. 토큰이 7개면 49칸이지만, 토큰이 10만 개면 100억 칸입니다. 계산량과 메모리가 문장 길이의 제곱으로 늘어나는 것이 트랜스포머의 가장 큰 약점이고, 2부의 여러 개선이 이 문제를 다룹니다.
실제 모델에서는 이런 패턴을 사람이 정해 주지 않습니다. 다음 토큰을 잘 맞추도록 학습하다 보면, 어떤 토큰이 어떤 토큰을 봐야 하는지가 가중치 행렬에 저절로 새겨집니다.
멀티헤드 어텐션: 여러 관점으로 동시에 보기
단어 사이의 관계는 한 가지가 아닙니다. “the dog bites the man.“에서 bites를 제대로 이해하려면 누가 물었는지(dog)와 누구를 물었는지(man)를 둘 다 알아야 합니다. 그런데 어텐션 하나는 행마다 가중치 분포를 하나만 만들기 때문에, 한쪽을 많이 보면 다른 쪽은 덜 보게 됩니다.
멀티헤드 어텐션(Multi-Head Attention) 은 어텐션을 여러 개(헤드) 나란히 돌려서 이 문제를 풉니다.
- 입력 X 전체로 Q, K, V를 만든 뒤, 열을 헤드 수만큼 나눠 갖습니다. 우리 위젯은 4차원이라 앞의 두 열은 헤드 1이, 뒤의 두 열은 헤드 2가 씁니다. 입력 자체를 쪼개는 것이 아니라, 모든 헤드가 같은 입력을 보되 서로 다른 가중치로 만든 열을 나눠 쓰는 것입니다.
- 헤드마다 자기 몫의 Q, K, V로 따로 어텐션을 계산합니다. 가중치가 다르기 때문에 헤드마다 다른 관계에 집중할 수 있습니다.
- 헤드들의 출력을 이어 붙여 원래 차원으로 되돌리고, 출력 가중치 $W_O$를 곱해 섞습니다.
실제 모델도 같은 구조입니다. Llama 2 7B는 4,096차원을 헤드 32개가 128차원씩 나눠 씁니다. 차원을 나눠 쓰기 때문에 헤드를 늘려도 전체 계산량은 거의 같습니다.
위젯에서 볼 점은 세 가지입니다.
- 헤드마다 가중치 표가 따로 나옵니다. 이 위젯에서는 헤드 1이 바로 앞의 명사를, 헤드 2가 뒤의 명사를 보도록 맞춰 두었습니다. 같은
bites행인데 두 표의 모양이 다릅니다. - 순서를 바꾸면 두 표가 함께 바뀝니다. “the man bites the dog.“를 누르면 두 헤드 모두 보는 대상이 바뀝니다. 입력이 바뀌면 모든 헤드의 Q, K가 함께 바뀌기 때문입니다.
- 결과는 하나로 합쳐집니다. 아래 줄처럼 헤드별 출력(각 7×2)을 이어 붙이면 7×4가 되고, $W_O$를 곱한 최종 출력이 다음 부품으로 넘어갑니다.
여기서도 헤드의 역할은 설명을 위해 정해 둔 것입니다. 실제 모델에서는 헤드마다 어떤 관계를 볼지 학습으로 정해지고, 분석해 보면 바로 앞 토큰을 보는 헤드, 문법적으로 연결된 단어를 보는 헤드처럼 역할이 나뉜 경우가 많습니다.
Add & Norm: 잔차 연결과 정규화
트랜스포머 구조 그림을 다시 보면 어텐션 바로 위에 Add & Norm 상자가 있습니다. 어텐션의 출력을 그대로 다음으로 넘기지 않고, 두 가지 처리를 먼저 거친다는 뜻입니다.
Add, 잔차 연결(residual connection). 어텐션의 출력을 어텐션에 들어간 입력에 더합니다. 셀프 어텐션에서 입력과 출력의 크기가 같다고 강조한 이유가 여기 있습니다. 크기가 같아야 칸끼리 더할 수 있습니다. 이렇게 하면 어텐션은 입력을 통째로 새로 만드는 대신 “입력에 무엇을 더 보탤지"만 배우면 됩니다. 원래 정보가 지워지지 않고 계속 흘러가기 때문에, 블록을 수십 층 쌓아도 학습이 잘 됩니다.
Norm, 층 정규화(LayerNorm). 더한 값은 층을 지날수록 커지거나 작아지면서 들쭉날쭉해지기 쉽습니다. LayerNorm은 토큰마다 벡터의 값을 평균 0, 표준편차 1이 되도록 맞춥니다. 벡터 x의 평균을 μ, 표준편차를 σ라고 하면 다음과 같습니다.
$$\mathrm{LayerNorm}(x) = \gamma \cdot \frac{x - \mu}{\sigma} + \beta$$γ와 β는 학습되는 값으로, 정규화한 뒤 모델이 필요한 만큼 크기와 위치를 다시 조정하게 해 줍니다. 위젯에서는 처음 값인 γ = 1, β = 0을 썼습니다.
위젯에서 볼 점은 세 가지입니다.
- 정규화는 토큰마다 따로 합니다. 행 하나(토큰 하나)의 4개 값끼리만 평균과 표준편차를 계산합니다. 다른 토큰의 값은 영향을 주지 않습니다.
- 크기는 사라지고 모양은 남습니다. 아래 그래프에서 정규화 전의 값은 평균이 0이 아니고 범위도 제각각이지만, 정규화 후에는 평균 0, 표준편차 1로 맞춰집니다. 그래도 어느 칸이 크고 어느 칸이 작은지, 즉 값들의 상대적인 모양은 그대로입니다.
- 결과의 크기는 여전히 7×4입니다. Add & Norm을 거쳐도 크기가 바뀌지 않으니, 다음 부품에 그대로 넘길 수 있습니다.
원래 트랜스포머는 이처럼 어텐션 뒤에 정규화를 했지만(Post-norm), 지금의 LLM은 대부분 어텐션 앞에 정규화를 합니다(Pre-norm). 층이 아주 깊어져도 학습이 더 안정적이기 때문입니다. Llama 같은 모델은 평균을 빼는 단계를 생략해 계산을 줄인 RMSNorm을 씁니다.
FFN: 토큰마다 혼자 생각하는 단계
어텐션은 토큰 사이에서 정보를 주고받는 장치입니다. 다른 토큰에서 필요한 정보를 모아 오기는 하지만, 모은 정보를 소화해서 새로운 특징을 만들어 내는 일은 거의 하지 않습니다. 그 역할을 블록의 두 번째 부품인 FFN(Feed-Forward Network) 이 맡습니다. 흔히 어텐션은 “주변을 둘러보는 단계”, FFN은 “혼자 생각하는 단계"라고 비유합니다.
FFN은 선형층 두 장과 그 사이의 활성화 함수로 된 작은 신경망입니다.
- 첫 번째 가중치 W₁로 차원을 4배로 넓힙니다. 우리 위젯은 4칸을 16칸으로 넓힙니다.
- ReLU로 음수를 모두 0으로 만듭니다. 이 단계가 없으면 선형층 두 장을 곱한 것이 결국 선형층 한 장과 같아져서, 층을 둘로 나눈 의미가 사라집니다.
- 두 번째 가중치 W₂로 다시 원래 차원으로 줄입니다.
위젯에서 볼 점은 세 가지입니다.
- 넓힌 칸의 상당수가 꺼집니다. 16칸으로 넓힌 값 중 음수인 칸은 ReLU를 지나면 0이 됩니다. 토큰마다 켜지는 칸의 조합이 다르고, 이 조합이 그 토큰이 어떤 특징을 가졌는지를 나타냅니다.
- 토큰마다 따로 계산합니다. 어느 토큰의 행을 골라도 계산에 쓰이는 것은 그 행과 W₁, W₂뿐입니다. 다른 토큰의 값은 섞이지 않습니다.
- 출력은 다시 7×4입니다. 크기가 그대로이니, 어텐션 때와 마찬가지로 입력에 더하고(잔차 연결) LayerNorm을 한 번 더 거칩니다. 구조 그림에서 FFN 위에 Add & Norm이 한 번 더 있는 이유입니다.
위젯의 W₁, W₂는 뒤에서 볼 다음 토큰 예측을 잘하도록 예문으로 학습시킨 값입니다. FFN은 모델 파라미터의 약 3분의 2를 차지하고, 모델이 학습한 사실 지식의 상당 부분이 여기에 저장된다고 봅니다. 지금의 LLM은 2부에서 볼 SwiGLU처럼 ReLU 대신 게이트를 단 변형을 많이 씁니다.
이것으로 트랜스포머 블록 하나가 끝납니다. 어텐션 → Add & Norm → FFN → Add & Norm을 거친 7×4 행렬이 다음 블록의 입력이 되고, 이 블록을 수십 번 반복합니다.
어텐션 마스크: 뒤에 오는 토큰 가리기
지금까지 본 어텐션에서는 모든 토큰이 문장 전체를 봤습니다. bites는 앞의 dog뿐 아니라 뒤의 man도 볼 수 있었습니다. 문장을 다 읽고 판단하는 모델이라면 이게 맞습니다. 2부에서 볼 BERT 같은 모델이 이렇게 양방향으로 봅니다.
그런데 GPT 같은 생성 모델은 다음 토큰을 맞히도록 학습합니다. 학습할 때는 문장 전체를 한 번에 넣고, 각 자리에서 그다음 토큰을 맞히게 합니다. 이때 bites 자리에서 다음 토큰 the를 맞혀야 하는데, 어텐션으로 뒤쪽을 볼 수 있으면 답을 보고 푸는 셈이 됩니다.
그래서 생성 모델은 인과 마스크(causal mask) 를 씌웁니다. 점수표에서 자기보다 뒤에 있는 칸, 즉 오른쪽 위 삼각형의 점수를 softmax 전에 -∞로 바꿉니다. softmax를 거치면 그 칸의 가중치는 0이 되고, 남은 칸들끼리 다시 합이 1이 되도록 나눠 갖습니다.
위젯에서 볼 점은 세 가지입니다.
- 각 토큰은 자기와 앞만 봅니다. 첫 토큰
<s>는 자기 자신만 볼 수 있고, 마지막 토큰.는 문장 전체를 볼 수 있습니다. 가중치 표의 오른쪽 위가 모두 비게 됩니다. - 가려진 몫은 남은 토큰들이 나눠 갖습니다. 아래 막대에서
bites행을 보면, 뒤쪽 토큰에 가던 가중치가 사라진 만큼 앞쪽 토큰들의 가중치가 커집니다. softmax는 남은 칸끼리 합이 1이 되도록 다시 나누기 때문입니다. - 뒤를 보는 관계는 성립하지 않습니다. 멀티헤드 위젯의 헤드 2처럼 뒤에 있는 토큰을 보는 가중치는 인과 마스크 아래에서는 만들어질 수 없습니다. 생성 모델이
bites를 만드는 시점에는 뒤의 토큰이 아직 없으니 당연한 일입니다.
인과 마스크 덕분에 생성 모델은 문장 하나로 모든 자리의 다음 토큰 예측을 동시에 학습할 수 있습니다. 7토큰 문장 하나가 “1개 보고 2번째 맞히기”, “2개 보고 3번째 맞히기” 같은 문제 여섯 개가 되는 셈입니다. 그리고 실제로 글을 생성할 때도 뒤쪽 토큰은 아직 없으니, 학습할 때와 같은 조건에서 동작합니다.
최종 출력: 다음 토큰 예측
블록을 수십 번 거친 마지막 행렬도 여전히 토큰 수 × 차원(7×4)입니다. 이제 각 행을 “다음에 올 토큰"에 대한 답으로 바꿔야 합니다.
- 출력층: 각 행에 출력 가중치 $W_{out}$(차원 × 사전 크기)을 곱해, 사전의 모든 토큰에 점수를 하나씩 매깁니다. 이 점수를 logit이라고 부릅니다. 우리 모델은 4차원을 토큰 11개의 점수로 바꾸고, Llama 2 7B는 4,096차원을 토큰 32,000개의 점수로 바꿉니다.
- softmax: 점수를 합이 1인 확률로 바꿉니다. i번째 행은 “i번째 토큰 다음에 무엇이 올까"에 대한 확률 분포입니다.
학습은 이 확률로 이루어집니다. 실제 다음 토큰의 확률을 p라고 하면 손실은 −log p이고, 이 값을 줄이도록 임베딩부터 어텐션, FFN, 출력층까지 모든 가중치를 한꺼번에 조정합니다. 앞의 마스크 절에서 본 것처럼 문장 하나로 모든 자리를 동시에 학습합니다.
생성은 이 확률로 토큰을 하나씩 고르는 일의 반복입니다. 마지막 자리의 확률에서 토큰 하나를 골라 문장 끝에 붙이고, 늘어난 문장을 다시 모델에 넣어 그다음 토큰을 고릅니다. 이렇게 앞에서 만든 결과를 다시 입력으로 쓰는 방식을 자기회귀(autoregressive) 생성이라고 합니다.
위젯에서 볼 점은 네 가지입니다.
- 확률은 예문의 통계를 따라갑니다.
<s>다음에는the가, 동사 다음에는 다시the가, 목적어 다음에는 마침표가 거의 확실하게 나옵니다. 반면the다음에는 dog, cat, man이 비슷한 확률로 나뉩니다. 예문 15개에서 셋이 고르게 나왔기 때문입니다. - 손실은 정답 확률에 달려 있습니다. 정답 확률이 0.98이면 손실은 0.02로 거의 0이고, 0.3이면 1.2로 커집니다. 학습은 이 손실의 평균을 줄이는 과정입니다.
- 고르는 방식에 따라 결과가 달라집니다. “가장 높은 것"은 매번 같은 문장을 만듭니다. “확률대로 뽑기"는 누를 때마다 다른 문장을 만듭니다. temperature를 올리면 확률이 평평해져 엉뚱한 토큰도 자주 나오고, 내리면 가장 높은 것만 고르는 쪽에 가까워집니다. ChatGPT의 답이 매번 조금씩 다른 이유가 이것입니다.
- 작은 모델은 실수도 합니다. 이 위젯의 어텐션 가중치는 설명을 위해 맞춘 값이고, FFN과 출력층만 예문 15개로 실제 학습시켰습니다. 그래서 “eats the” 다음에 fish가 와야 한다는 것까지는 배우지 못했고, 뽑기 모드에서는 가끔 문법이 틀린 문장도 나옵니다. 실제 LLM은 수천억 개의 파라미터로 수조 개의 토큰을 학습해서 이런 관계를 훨씬 정교하게 배웁니다.
생성 과정을 잘 보면 토큰을 하나 붙일 때마다 문장 전체를 처음부터 다시 계산합니다. 앞쪽 토큰들의 계산은 매번 똑같은데도 그렇습니다. 이 낭비를 없애는 것이 2부에서 볼 KV 캐시입니다.
여기까지가 트랜스포머 하나가 문장을 받아 다음 토큰을 내놓기까지의 전 과정입니다. 토큰화, 임베딩, 위치 인코딩을 거친 입력이 어텐션, Add & Norm, FFN으로 된 블록을 지나고, 출력층에서 다음 토큰의 확률이 됩니다.
2부. 트랜스포머 디자인 변형들
2017년 원본 트랜스포머의 설계는 대부분 지금도 그대로 쓰입니다. 다만 몇 군데는 더 나은 대안이 나와 교체되었습니다. 크게 네 가지입니다.
- 구조: 인코더-디코더, 인코더만, 디코더만
- 위치 인코딩: 절대 위치에서 상대 위치로
- 어텐션: KV 캐시를 줄이는 MQA, GQA
- FFN: 게이트를 단 SwiGLU
세 가지 구조: T5, BERT, GPT
원래 트랜스포머는 인코더와 디코더 두 부분으로 되어 있었습니다. 인코더는 입력 문장 전체를 양방향으로 읽어 이해하고, 디코더는 그 이해를 바탕으로 출력 문장을 한 토큰씩 생성합니다. 번역을 위해 설계된 구조입니다. 이후 두 부분을 떼어 각자 쓰는 방식이 나오면서 세 갈래로 나뉘었습니다.
인코더-디코더 (T5). 구글의 T5는 번역, 요약, 분류, 문장 유사도 측정까지 모든 문제를 “텍스트를 넣으면 텍스트가 나온다"는 형식으로 통일했습니다. 예를 들어 “translate English to German: That is good.“을 넣으면 “Das ist gut.“이 나오고, 감성 분류도 “positive"라는 텍스트로 답합니다. 프롬프트는 인코더가 읽고, 답은 디코더가 생성합니다.
인코더만 (BERT). 2018년 구글의 BERT는 인코더만 씁니다. 양방향 어텐션으로 문장 전체를 보고, 입력 토큰의 15%를 가린 뒤 가려진 단어를 맞추는 빈칸 채우기(Masked Language Model) 로 학습합니다. 문장을 깊이 이해하는 데 강해서 분류, 검색, 문장 임베딩에 지금도 널리 쓰입니다. 생성은 못 하지만 작고 빠르다는 장점이 있습니다. 실제 서비스에서 인코더를 어떻게 쓰는지는 인코더 전략 글에서 다뤘습니다.
같은 조건이라면 양방향이 얼마나 나을까요? 데이터와 모델 구조, 학습 방법을 모두 똑같이 두고 인코더와 디코더를 크기별로 짝지어 학습한 Ettin 연구(Weller et al., 2025)를 보면 답이 분명합니다. 분류와 검색은 모든 크기에서 인코더가, 생성은 모든 크기에서 디코더가 앞섭니다. 400M 인코더가 2.5배 큰 1B 디코더보다 MNLI(문장 관계 분류)에서 더 높습니다.
| 크기 | MNLI 정확도 (인코더 / 디코더) | 생성 과제 평균 (인코더 / 디코더) |
|---|---|---|
| 150M | 89.2 / 85.6 | 42.9 / 46.2 |
| 400M | 91.3 / 88.2 | 48.2 / 53.1 |
| 1B | 91.8 / 89.9 | 50.7 / 59.0 |
BERT 원 논문의 실험에서도 같은 모델을 GPT식 단방향으로 학습하자 질의응답(SQuAD) 점수가 87.9에서 77.8로 10점 넘게 떨어졌습니다(Devlin et al., 2018, Table 5). 학습 목표만 바꿔 비교한 다른 연구도 질의응답에서 차이가 가장 크고, 모델이 커질수록 차이가 벌어진다고 보고합니다(Gisserot-Boukhlef et al., 2025). 그래서 요즘은 디코더 LLM도 임베딩용으로 쓸 때 인과 마스크를 풀어 양방향으로 바꾼 뒤 짧게 추가 학습하기도 합니다(LLM2Vec).
디코더만 (GPT). OpenAI의 GPT는 디코더만 씁니다. 인과 마스크로 앞 토큰만 보면서 다음 토큰 맞추기 하나만 학습합니다. 단순해 보이지만, 다음 단어를 잘 맞추려면 문법, 사실 지식, 논리, 문맥을 모두 알아야 합니다. 그리고 인터넷의 모든 텍스트가 별도 라벨 없이 그대로 학습 데이터가 됩니다. 사람이 정답을 달아 줄 필요 없이, 문장의 다음 단어 자체가 정답이기 때문입니다. 데이터를 무한히 늘릴 수 있는 구조라서 규모를 키우기에 가장 유리했고, 지금의 LLM은 거의 모두 디코더만 쓰는 구조입니다.
위치 인코딩의 진화: 절대에서 상대로
1부에서 본 절대 위치 인코딩은 “이 토큰은 37번째"라는 정보를 임베딩에 더합니다. 문제는 학습할 때 본 적 없는 위치에서 생깁니다. 2,048 토큰까지만 학습한 모델에 5,000번째 위치를 주면 처음 보는 값이라 성능이 무너집니다.
그런데 언어에서 중요한 것은 대개 절대 위치보다 상대 거리입니다. “바로 앞 단어”, “세 단어 전"이 “37번째 단어"보다 의미가 있습니다. 상대 위치 인코딩은 위치 정보를 임베딩에 더하는 대신, 어텐션 점수를 계산할 때 두 토큰 사이의 거리를 반영합니다. ALiBi처럼 거리에 비례해 점수를 깎는 단순한 방법도 있고, 지금 가장 널리 쓰이는 것은 RoPE입니다.
RoPE(Rotary Positional Embedding) 는 Query와 Key 벡터를 위치만큼 회전시킵니다. 벡터의 원소를 두 개씩 짝지어 2차원 평면의 좌표로 보고, m번째 토큰이면 각도 m×θ만큼 돌립니다. 두 벡터를 내적하면 회전 각도의 차이만 남기 때문에, 어텐션 점수는 자연스럽게 두 토큰의 상대 거리(m-n)에만 의존하게 됩니다. LLaMA 이후 대부분의 오픈 모델이 RoPE를 씁니다.
RoPE는 컨텍스트 확장에도 유리합니다. 2,048 토큰으로 학습한 모델에 회전 각도를 절반으로 줄여(위치 보간, Position Interpolation) 넣으면, 4,096번째 위치도 학습 때 본 각도 범위 안에 들어옵니다. 짧은 추가 학습만으로 LLaMA의 컨텍스트를 2K에서 32K까지 늘린 연구가 있고, 이후 모델들이 128K, 100만 토큰까지 컨텍스트를 넓힌 데에도 이런 기법들이 쓰였습니다.
위젯에서 볼 점은 두 가지입니다.
- 회전은 절대 위치로, 결과는 상대 거리로. 각 토큰은 자기 위치만큼 돌아갑니다. Query와 Key가 같은 규칙으로 돌기 때문에, 둘을 내적하면 두 회전 각도의 차이, 즉 상대 거리만 남습니다. 위치 정보를 임베딩에 더하지 않고 Query와 Key에만 반영한다는 점도 1부의 절대 위치 인코딩과 다릅니다.
- 빠른 쌍과 느린 쌍. 앞쪽 차원 쌍(d1·d2)은 위치마다 크게, 뒤쪽 쌍(d3·d4)은 조금씩 돕니다. 빠른 바늘은 가까운 거리를, 느린 바늘은 먼 거리를 구분합니다.
KV 캐시: 생성 속도의 비밀이자 메모리 문제
GPT 같은 모델이 문장을 생성하는 과정을 보겠습니다. 토큰을 하나 만들 때마다 지금까지의 모든 토큰을 보고 다음 토큰을 예측합니다. 100번째 토큰을 만들 때 앞 99개 토큰의 Key와 Value가 필요합니다.
그런데 인과 마스크 덕분에 앞 토큰들의 Key와 Value는 뒤에 무엇이 오든 바뀌지 않습니다. 그래서 한 번 계산한 Key와 Value를 저장해 두고 재사용합니다. 이것이 KV 캐시입니다. 새 토큰을 만들 때는 그 토큰의 Query, Key, Value만 새로 계산합니다. Query는 캐시된 Key, Value와 어텐션을 하고, 새 Key와 Value는 캐시에 덧붙입니다. KV 캐시가 없으면 토큰마다 앞부분 전체를 다시 계산해야 해서 생성이 매우 느려집니다.
문제는 이 캐시의 크기입니다. 토큰 하나당 저장해야 하는 양은 이렇게 계산합니다.
$$\text{층 수} \times \text{KV 헤드 수} \times \text{헤드 차원} \times 2\,(K, V) \times 2\,\text{bytes}$$Llama 2 7B(32층, 32헤드, 헤드 차원 128)는 토큰 하나에 512KB입니다. 70B 모델을 멀티헤드 어텐션 그대로 쓴다면(80층, 64헤드) 토큰당 2.5MB가 됩니다.
| 설정 (Llama 2 70B, MHA 가정) | KV 캐시 크기 |
|---|---|
| 사용자 1명, 512 토큰 | 1.25GB |
| 사용자 1명, 4,096 토큰 | 10GB |
| 사용자 16명, 4,096 토큰 | 160GB (A100 80GB 두 장) |
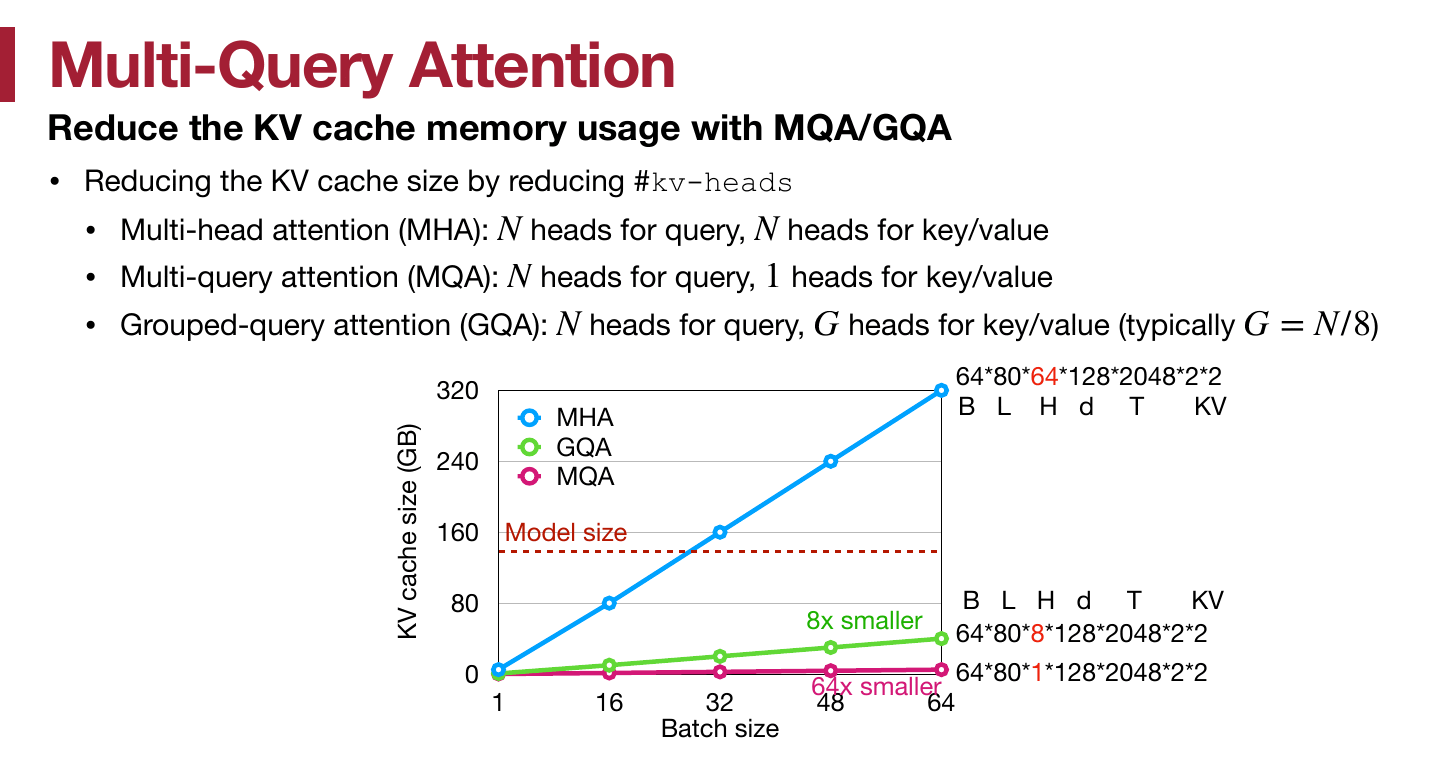
출처: Song Han, MIT 6.5940 Lecture 12: Transformer and LLM
배치가 조금만 커져도 KV 캐시가 모델 가중치보다 커집니다. LLM 서빙에서 GPU 메모리를 가장 많이 잡아먹는 것이 모델 자체가 아니라 KV 캐시인 경우가 흔합니다. 컨텍스트가 길수록, 동시 사용자가 많을수록 서빙 비용이 커지는 직접적인 이유입니다.
MQA와 GQA: KV 헤드를 나눠 쓰기
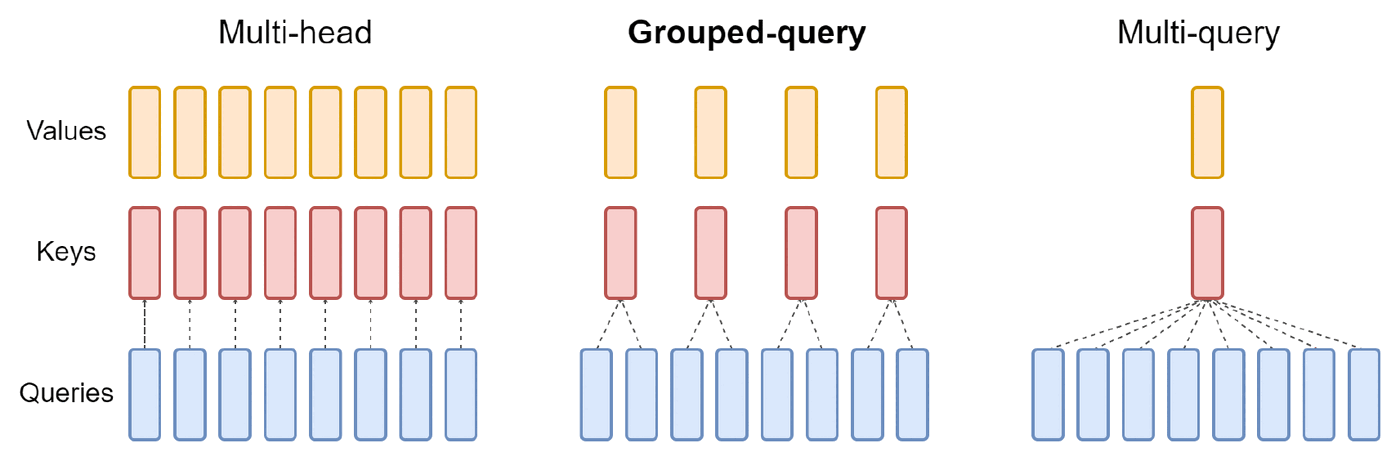
출처: Ainslie et al., GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints, EMNLP 2023, Figure 2
KV 캐시 크기는 KV 헤드 수에 비례합니다. 그렇다면 KV 헤드를 줄이면 됩니다.
- MHA(Multi-Head Attention): Query 헤드 N개, Key/Value 헤드도 N개. 원래 방식입니다.
- MQA(Multi-Query Attention): Query 헤드는 N개 그대로, Key/Value 헤드는 1개를 모두가 공유합니다. 캐시가 N분의 1로 줄지만 품질이 떨어질 수 있습니다.
- GQA(Grouped-Query Attention): Query 헤드를 몇 개 그룹으로 묶고, 그룹마다 Key/Value 헤드를 하나씩 둡니다. 보통 N/8개를 씁니다.
가중치로 보면 $W_Q$는 그대로이고, $W_K$와 $W_V$의 열이 KV 헤드 수만큼으로 줄어듭니다. Llama 2 70B는 Query 헤드 64개에 KV 헤드 8개인 GQA를 써서 KV 캐시를 8분의 1로 줄였습니다. $W_Q$는 8,192×8,192 그대로이고, $W_K$와 $W_V$는 각각 8,192×1,024입니다. 위의 160GB가 20GB가 되는 셈입니다. 실험해 보면 큰 모델에서 GQA의 정확도는 MHA와 거의 같습니다. 지금은 대부분의 오픈 모델이 GQA를 씁니다.
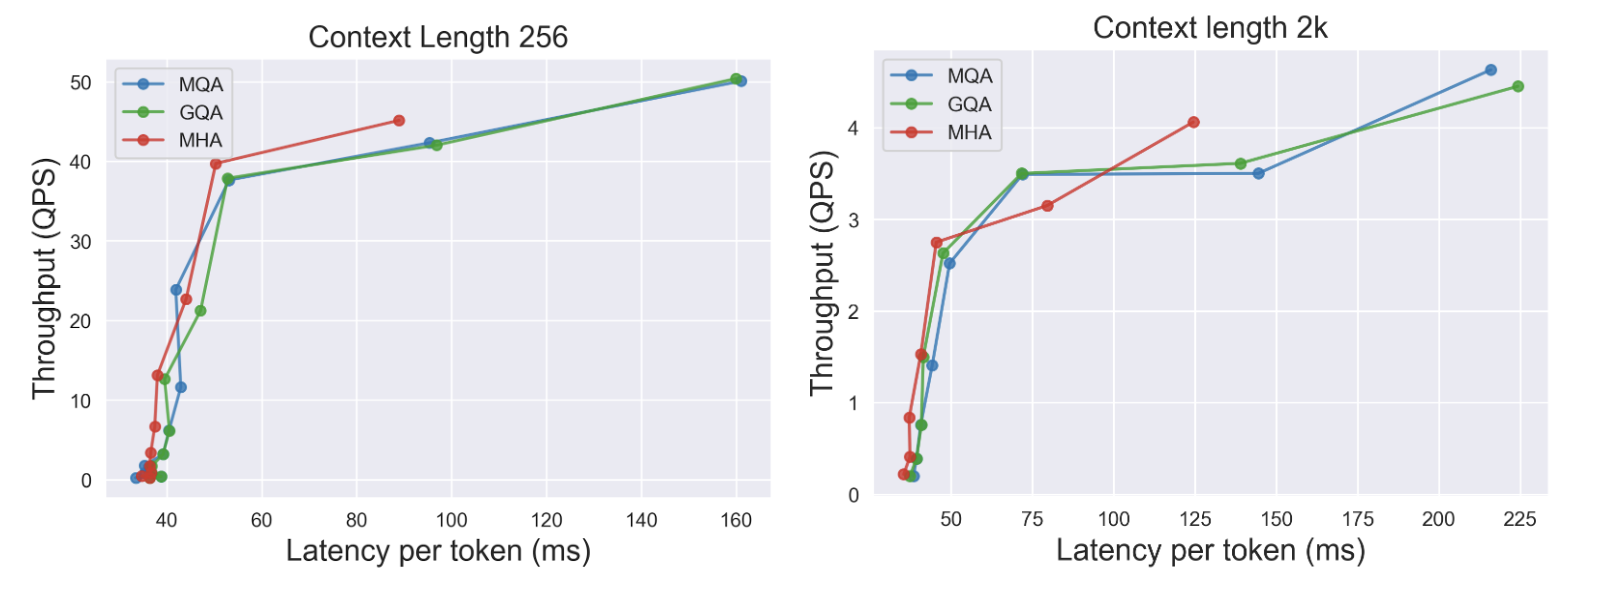
출처: Touvron et al., Llama 2: Open Foundation and Fine-Tuned Chat Models, 2023, Figure 24
서빙 관점에서 보면 차이가 더 분명합니다. 위 그림은 Llama 2 연구에서 300억 파라미터 모델을 세 방식으로 각각 학습한 뒤, A100 80GB 8장에서 배치 크기를 1부터 두 배씩 키우며 잰 결과입니다. 왼쪽 아래 점이 배치 1이고 오른쪽으로 갈수록 배치가 큽니다. 배치가 작을 때는 세 방식의 지연이 비슷하지만, MHA는 KV 캐시가 GPU 메모리를 채워 배치를 더 키우지 못하고 멈춥니다. 컨텍스트 2K에서는 배치 128에서 메모리가 부족해집니다. MQA와 GQA는 그 뒤로도 배치를 키워 처리량을 더 끌어올립니다.
이 흐름은 계속되고 있습니다. DeepSeek-V2에서 처음 도입한 MLA(Multi-head Latent Attention) 는 Key와 Value를 작은 잠재 벡터로 압축해 저장했다가 필요할 때 복원하는 방식으로, GQA보다 캐시를 더 줄이면서 품질을 유지합니다.
FFN에서 SwiGLU로
FFN에도 작은 개선이 있었습니다. 원래 FFN은 “넓히기 → ReLU → 줄이기"였고, 넓힌 칸을 켤지 끌지는 그 칸의 값 자신이 정했습니다. SwiGLU는 입력을 두 번 넓힙니다. 하나(xV)는 내보낼 내용이고, 다른 하나(xW)는 Swish를 거쳐 각 칸을 얼마나 통과시킬지 정하는 문지기(게이트)입니다. 둘을 칸끼리 곱한 뒤 W₂로 줄입니다. “무엇을 내보낼지"와 “얼마나 내보낼지"를 따로 배울 수 있어서, 같은 파라미터 수에서 성능이 더 좋습니다. LLaMA 이후 사실상 표준입니다.
실제 수치로 보면 이렇습니다. 파라미터 수와 계산량을 같게 맞춘 T5 크기 모델을 빈칸 채우기 과제로 학습한 결과인데, 값이 작을수록 좋습니다.
| FFN 종류 | 65,536 스텝 | 524,288 스텝 |
|---|---|---|
| ReLU (원래 FFN) | 1.997 | 1.677 |
| GELU | 1.983 | 1.679 |
| Swish | 1.994 | 1.683 |
| GLU | 1.982 | 1.663 |
| Bilinear | 1.960 | 1.648 |
| GEGLU | 1.942 | 1.633 |
| SwiGLU | 1.944 | 1.636 |
| ReGLU | 1.953 | 1.645 |
출처: Shazeer, GLU Variants Improve Transformer, 2020, Table 1 (heldout log-perplexity)
활성 함수만 바꾼 위 세 줄은 거의 차이가 없고, 게이트를 단 아래 다섯 줄이 모두 더 낫습니다. 즉 효과의 대부분은 Swish 자체가 아니라 게이트 구조에서 옵니다.
$$\mathrm{FFN}_{\mathrm{SwiGLU}}(x) = \big(\mathrm{Swish}(xW) \otimes xV\big)\, W_2$$계산 그래프로 비교하면 차이가 분명합니다. 원래 FFN은 한 줄로 내려가는 반면, SwiGLU는 입력에서 두 갈래로 갈라졌다가 칸끼리 곱하는 지점에서 다시 합쳐집니다.
대신 가중치 행렬이 두 장(W₁, W₂)에서 세 장(W, V, W₂)으로 늘어납니다. 그래서 전체 파라미터 수를 원래와 맞추려고 가운데 폭을 줄입니다.
| 가중치 행렬 | 가운데 폭 | 파라미터 수 | |
|---|---|---|---|
| 원래 FFN | 2장 | 4d | 2 × d × 4d = 8d² |
| SwiGLU | 3장 | 8d/3 (약 2.7d) | 3 × d × 8d/3 = 8d² |
Llama 2 7B가 4,096차원을 4배인 16,384가 아니라 11,008칸으로 넓히는 이유가 이것입니다. 8d/3 ≈ 10,923을 계산하기 좋은 크기로 올린 값입니다.
정리하면, 2부의 변형들은 대부분 “더 길게, 더 싸게” 돌리기 위한 개선입니다. 더 긴 문맥을 다루기 위한 RoPE, 생성 비용을 줄이기 위한 KV 캐시와 GQA가 그렇습니다. 이 부품들이 실제 모델에 어떻게 조립되었는지는 3부에서 확인하겠습니다.
3부. LLMs
크게 키우면 달라진다
LLM(Large Language Model) 은 결국 크게 키운 트랜스포머입니다. 자연어와 코드 같은 거대한 텍스트로 학습합니다. 2018년 GPT-1은 1억 1,700만 파라미터였고, 2019년 GPT-2는 15억, 2020년 GPT-3는 1,750억 파라미터였습니다. 2년 만에 1,000배 넘게 커진 셈입니다. 같은 기간 GPU 메모리는 몇 배밖에 늘지 않아서, 모델 하나를 여러 GPU에 나눠 돌리는 기술과 이 시리즈에서 다룬 양자화 같은 경량화 기술이 필요해졌습니다.
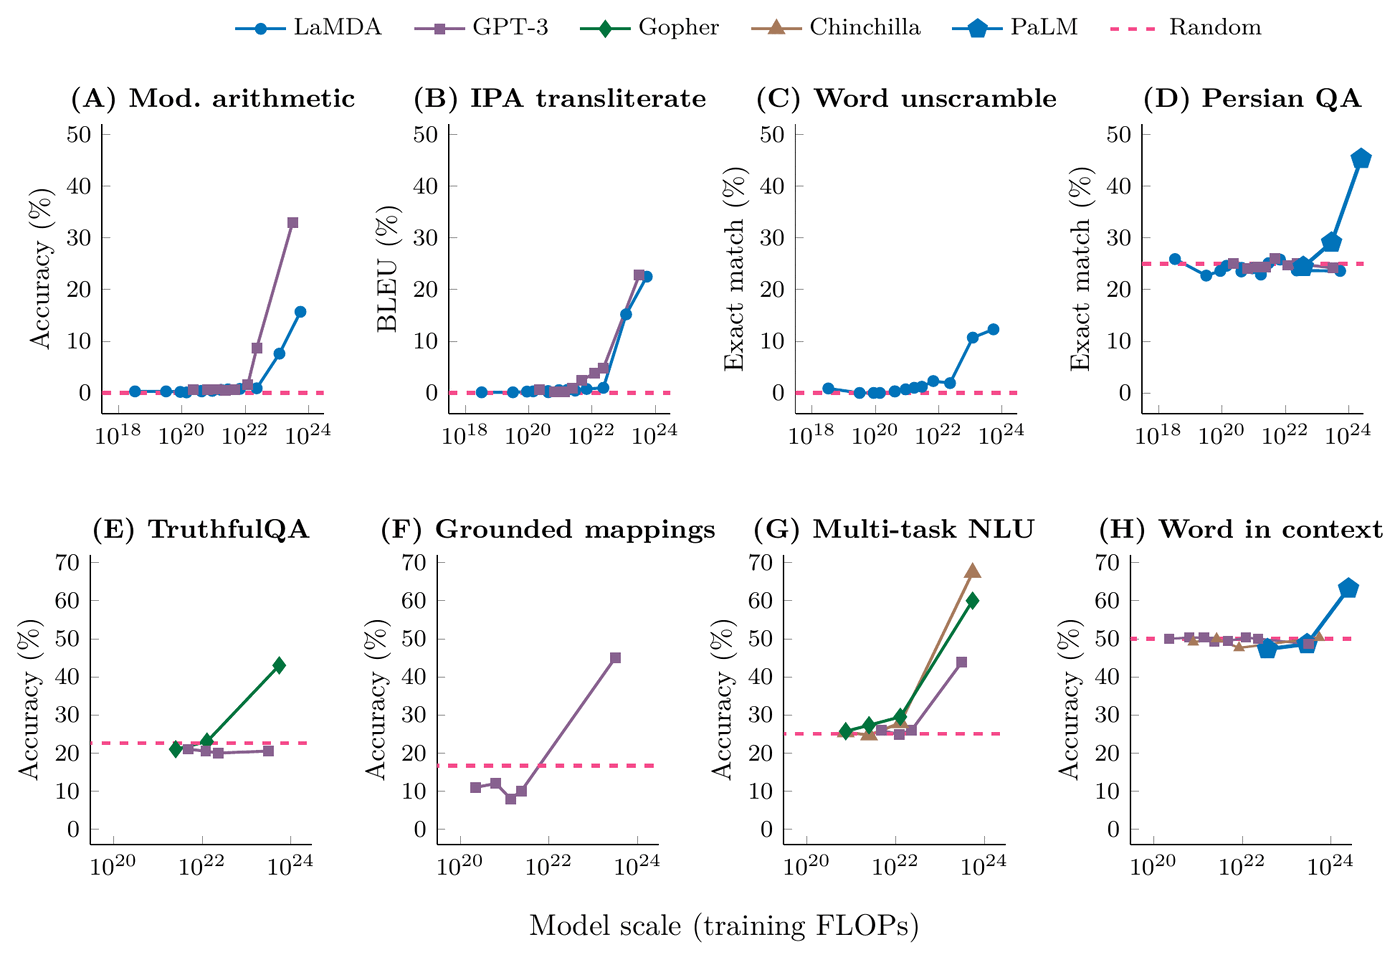
출처: Wei et al., Emergent Abilities of Large Language Models, TMLR 2022, Figure 2
흥미로운 점은 크기를 키울 때 성능이 고르게 오르기만 하는 것이 아니라는 점입니다. 규칙이 바뀐 산술 문제, 발음 기호로 옮겨 적기, 뒤섞인 철자 맞추기, 페르시아어 질의응답 같은 과제에서 작은 모델은 거의 찍는 수준이다가, 어느 규모를 넘는 순간 정확도가 갑자기 뛰어오릅니다. 이를 창발 능력(emergent abilities) 이라고 부릅니다. 이후 연구에서는 이것이 평가 지표를 정답/오답으로만 매긴 탓에 급격해 보이는 것이고, 연속적인 지표로 보면 꾸준히 오른다는 반론도 나왔습니다. 어느 쪽이든 규모가 커질수록 이전에 못 하던 일을 하게 된다는 점은 같습니다.
GPT-3와 인컨텍스트 러닝
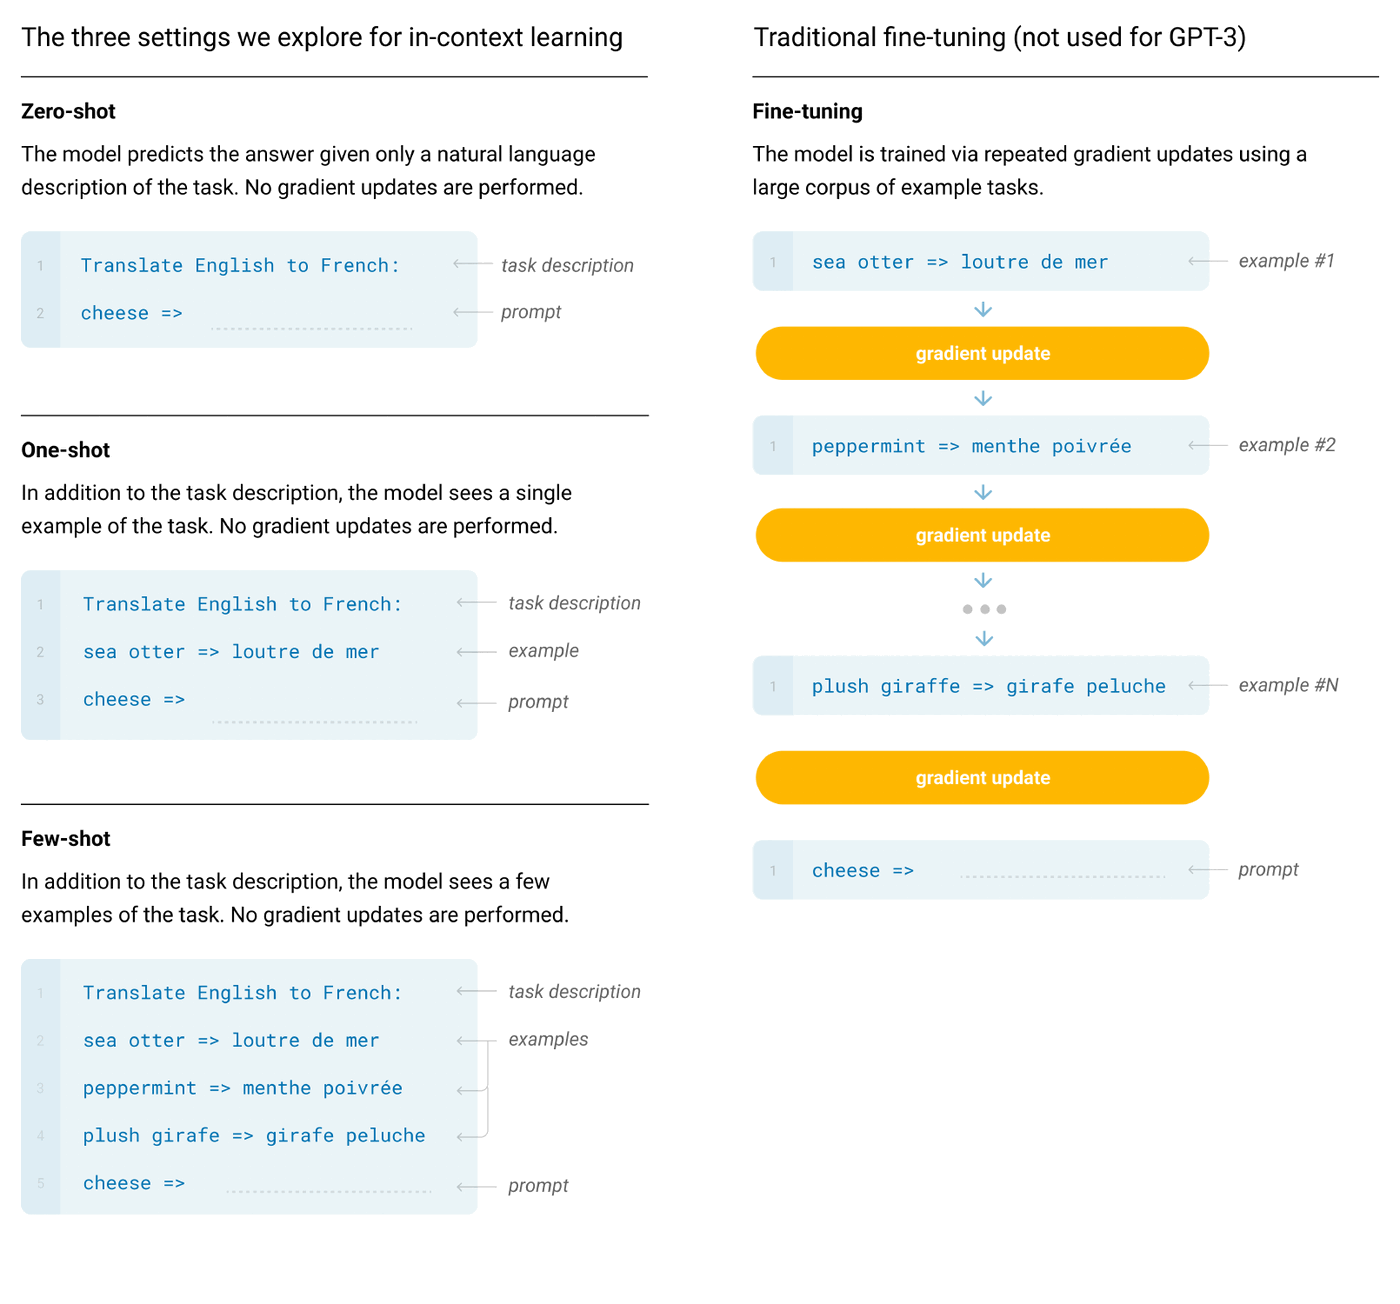
출처: Brown et al., Language Models are Few-Shot Learners, NeurIPS 2020, Figure 2.1
GPT-3 이전의 표준 방식은 사전학습 후 파인튜닝이었습니다. 큰 텍스트로 모델을 미리 학습한 뒤, 감성 분류를 하려면 감성 분류 데이터 수천 건으로, 번역을 하려면 번역 데이터로 모델을 다시 학습했습니다. 과제마다 데이터를 모으고 모델을 따로 만들어야 했습니다.
GPT-3는 이 방식을 바꿨습니다. 모델을 다시 학습하지 않고, 프롬프트에 설명이나 예시만 넣어도 새 과제를 수행합니다.
- 제로샷(zero-shot): “영어를 프랑스어로 번역하세요: cheese =>” 처럼 과제 설명만 줍니다.
- 퓨샷(few-shot): 설명에 더해 “sea otter => loutre de mer”, “peppermint => menthe poivrée” 같은 예시를 몇 개 보여 준 뒤 문제를 냅니다.
이를 인컨텍스트 러닝(in-context learning) 이라고 합니다. 모델의 가중치는 전혀 바뀌지 않았는데, 입력(컨텍스트) 안의 예시를 보고 그 자리에서 패턴을 파악합니다. 모델이 클수록 예시를 더 잘 활용하고, 예시를 충분히 주면 과제 설명이 없어도 설명을 준 것만큼 잘합니다.
실무 관점에서 이것이 프롬프트 엔지니어링이 효과 있는 이유입니다. 원하는 출력 형식의 예시 두세 개를 넣는 것만으로 결과가 크게 좋아지는 경우가 많습니다. 파인튜닝은 프롬프트로 해결되지 않을 때 고려하는 다음 단계가 되었습니다.
오픈 모델의 계보: 부품이 조립되는 과정
GPT-3 이후 OpenAI는 모델 구조와 크기를 공개하지 않았습니다. GPT-4의 파라미터 수는 지금도 공식적으로 알려져 있지 않습니다. 대신 Meta를 중심으로 공개 모델이 빠르게 발전했고, 2부에서 본 부품들이 어떻게 조립되는지 이 계보에서 잘 보입니다.
OPT (Meta, 2022). GPT-3를 재현해 공개한 모델로 1억 2,500만에서 1,750억 파라미터까지 다양한 크기를 냈습니다. 디코더만 쓰는 구조, Pre-norm, ReLU 활성화를 썼고 성능은 GPT-3와 비슷했습니다.
LLaMA (Meta, 2023). 70억에서 650억 파라미터. 여기서 지금의 표준 조합이 자리 잡았습니다. 디코더만 + Pre-norm + SwiGLU + RoPE입니다. 130억짜리 LLaMA가 1,750억짜리 GPT-3보다 여러 벤치마크에서 나았습니다. 모델 크기를 키우는 대신 데이터를 1조 토큰 이상으로 늘린 결과입니다.
Llama 2 (2023). 컨텍스트를 2K에서 4K로 늘리고 학습 데이터를 2조 토큰으로 늘렸습니다. 70B 모델에는 GQA를 넣었습니다. 대화에 맞게 인스트럭션 튜닝한 Llama-2-chat도 함께 공개했습니다.
Llama 3 (2024). 학습 데이터를 15조 토큰 이상으로 크게 늘렸고, 최대 모델은 4,050억 파라미터입니다. Llama 3.1부터 컨텍스트가 128K로 늘었습니다. 학습 후 다듬는 과정도 단순화해서, 지도 학습(SFT), 좋은 답만 골라 다시 학습하기(rejection sampling), 사람이 선호하는 답 쪽으로 학습하기(DPO)를 반복했습니다.
Mistral 7B (2023). 70억 파라미터로 Llama 2 13B를 넘었습니다. GQA를 쓰고 컨텍스트를 8K로 늘렸습니다. 잘 만든 작은 모델이 두 배 큰 모델을 이길 수 있다는 것을 보여 주었습니다.
2025–2026년의 공개 모델. 이후 공개 모델의 중심은 중국 연구실로 옮겨 갔습니다. DeepSeek, Qwen(알리바바), Kimi(Moonshot), GLM(z.ai)이 공개 모델 상위권을 주로 차지하고, 크기는 수천억에서 1조 파라미터를 넘는 수준이 되었습니다. 이 모델들은 거의 모두 MoE입니다(4부 끝에서 다룹니다). 어텐션 방식은 연구실마다 달라서, Kimi K2.5와 GLM-5는 2부에서 본 DeepSeek의 MLA를 씁니다. 다음 토큰 하나가 아니라 여러 개를 함께 예측하도록 학습하는 MTP(Multi-Token Prediction) 도 DeepSeek-V3 이후 학습 효율과 생성 속도를 높이는 장치로 자리 잡았습니다.
어떻게 키워야 하나: Chinchilla 법칙
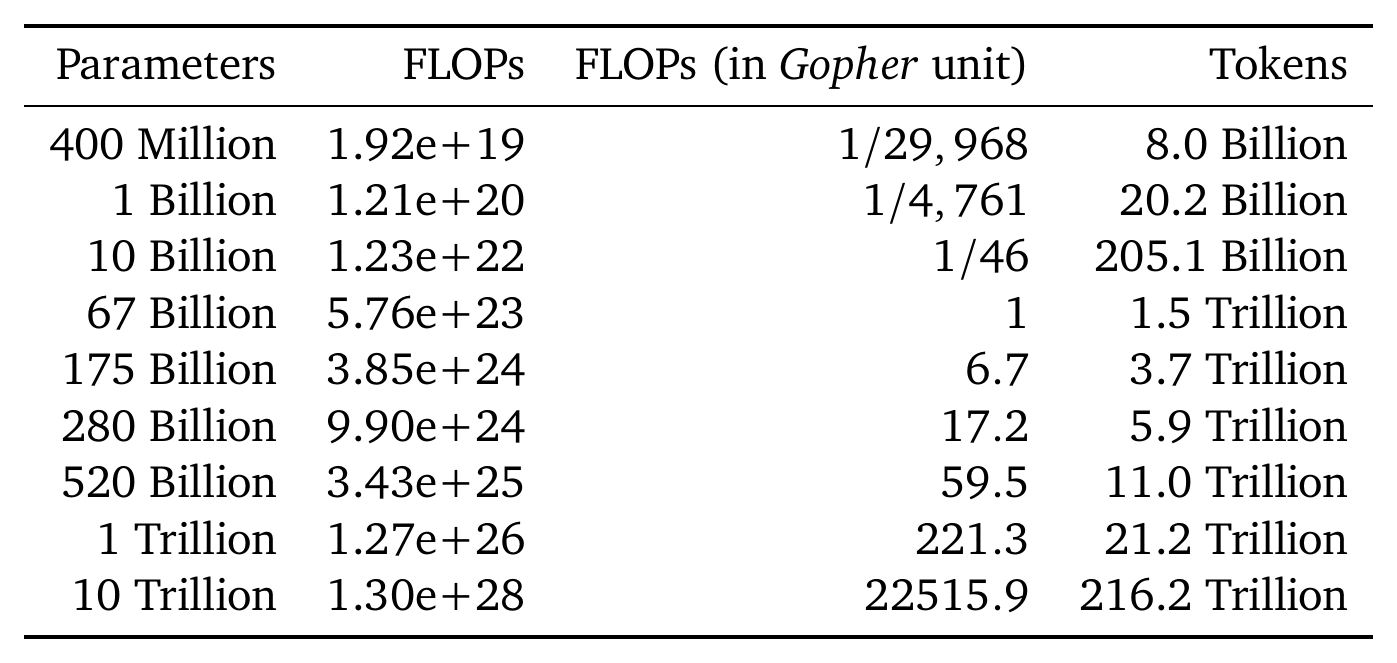
출처: Hoffmann et al., Training Compute-Optimal Large Language Models, NeurIPS 2022, Table 3
같은 계산 예산이 있을 때 모델을 키우는 게 나을까, 데이터를 늘리는 게 나을까? 2022년 DeepMind의 Chinchilla 연구는 둘을 같은 비율로 함께 키워야 한다는 결론을 냈습니다. 대략 파라미터 1개당 학습 토큰 20개가 최적입니다. 이 기준으로 보면 GPT-3(1,750억)나 Gopher(2,800억)는 크기에 비해 데이터가 부족했습니다. Gopher보다 4배 작은 Chinchilla(700억)가 데이터를 4배 더 써서 두 모델을 모두 이겼습니다.
다만 이 법칙은 학습 비용만 따진 것입니다. 실제 서비스에서는 학습은 한 번이지만 추론은 매일 수백만 번 합니다. 추론 비용은 모델 크기에 비례하므로, 학습 비용을 조금 더 쓰더라도 작은 모델을 훨씬 오래 학습하는 편이 전체적으로 이득입니다. Llama 2 7B는 2조 토큰(파라미터당 약 285개), Llama 3 8B는 15조 토큰으로 학습했습니다. Chinchilla 기준의 10배가 넘습니다. 작은 모델(SLM)을 잘 학습하거나 파인튜닝해서 쓰는 전략이 사업적으로 의미가 있는 이유이기도 합니다.
최근 흐름: 오래 생각하는 모델, 학습 후 다듬기, 디퓨전
2024년 이후 LLM 발전에는 세 가지 흐름이 더해졌습니다.
첫째, 추론(reasoning) 모델입니다. OpenAI o1(2024), DeepSeek-R1(2025) 같은 모델은 답하기 전에 긴 사고 과정을 먼저 생성합니다. 문제를 쪼개고, 시도하고, 틀리면 되돌아갑니다. 그동안은 “학습할 때 계산을 더 쓰면 똑똑해진다"였다면, 여기에 “답할 때 계산을 더 쓰면 똑똑해진다”(test-time compute) 라는 새로운 축이 생겼습니다. 수학, 코딩처럼 단계적 사고가 필요한 문제에서 큰 향상을 보였습니다.
둘째, 학습 후 다듬기(post-training)의 비중이 커졌습니다. 사전학습만 마친 모델은 다음 단어를 잘 맞출 뿐 질문에 답하는 비서가 아닙니다. 그래서 여러 단계를 더 거칩니다.
- 인스트럭션 튜닝(instruction tuning): “요약해 줘”, “번역해 줘” 같은 지시문과 모범 답안 쌍으로 지도 학습(SFT)해서, 다음 단어를 잇는 모델을 지시를 따르는 비서로 바꿉니다.
- 선호 학습(RLHF, DPO): 같은 질문의 두 답 중 사람이 더 좋다고 고른 쪽으로 학습해 더 유용하고 안전한 답을 하도록 다듬습니다.
- 검증 가능한 보상으로 강화학습: 수학 정답이나 코드 테스트 통과처럼 맞고 틀림을 자동으로 판정할 수 있는 문제로 강화학습을 합니다. 추론 모델의 긴 사고 능력이 주로 이 단계에서 길러집니다.
Hugging Face에서 모델을 고를 때 이름 끝을 보면 이 구분을 알 수 있습니다. gemma-3-4b-it의 -it(instruction-tuned), Llama-3.1-8B-Instruct나 Qwen2.5-7B-Instruct의 -Instruct, Llama-2-7b-chat-hf의 -chat이 모두 인스트럭션 튜닝까지 마친 모델입니다. 반대로 gemma-3-4b-pt의 -pt(pretrained)나 -Base가 붙은 모델은 사전학습만 마친 모델이라, 질문을 넣으면 답하는 대신 글을 이어 쓰려고 합니다. 바로 대화에 쓰려면 -it나 -Instruct 쪽을, 내 데이터로 직접 파인튜닝하려면 Base 쪽을 고르는 것이 보통입니다.
셋째, 다음 토큰 예측 자체를 바꾸려는 시도입니다. 지금까지 본 LLM은 모두 토큰을 하나씩 순서대로 생성합니다. 디퓨전 언어 모델은 이미지 생성 모델처럼 답안 전체의 초안을 먼저 만들고, 여러 번에 걸쳐 동시에 다듬습니다. Inception의 Mercury 2(2026년 2월)는 추론 기능을 갖춘 첫 디퓨전 LLM이라며 초당 1,000 토큰 이상의 속도를 내세웠습니다. 구글도 2025년에 Gemini Diffusion을 시연했지만 아직 연구 단계입니다. 속도 수치는 회사 발표이고, 품질이 기존 방식을 따라잡을지는 더 지켜봐야 합니다.
4부. 멀티모달리티
보는 LLM
2023년 GPT-4V는 이미지를 입력으로 받기 시작했습니다. 영수증 사진을 보고 금액을 계산하고, 메뉴판을 읽고, 신분증 사진에서 정보를 뽑아 JSON으로 정리합니다. 글자만 다루던 LLM이 어떻게 이미지를 보게 되었을까요? 크게 두 가지 방법이 있습니다.
- 크로스어텐션으로 이미지 정보를 끼워 넣기 (Flamingo 방식)
- 이미지를 토큰으로 바꿔 입력에 넣기 (PaLM-E 방식)
Flamingo: LLM은 그대로 두고 옆에서 보여 주기
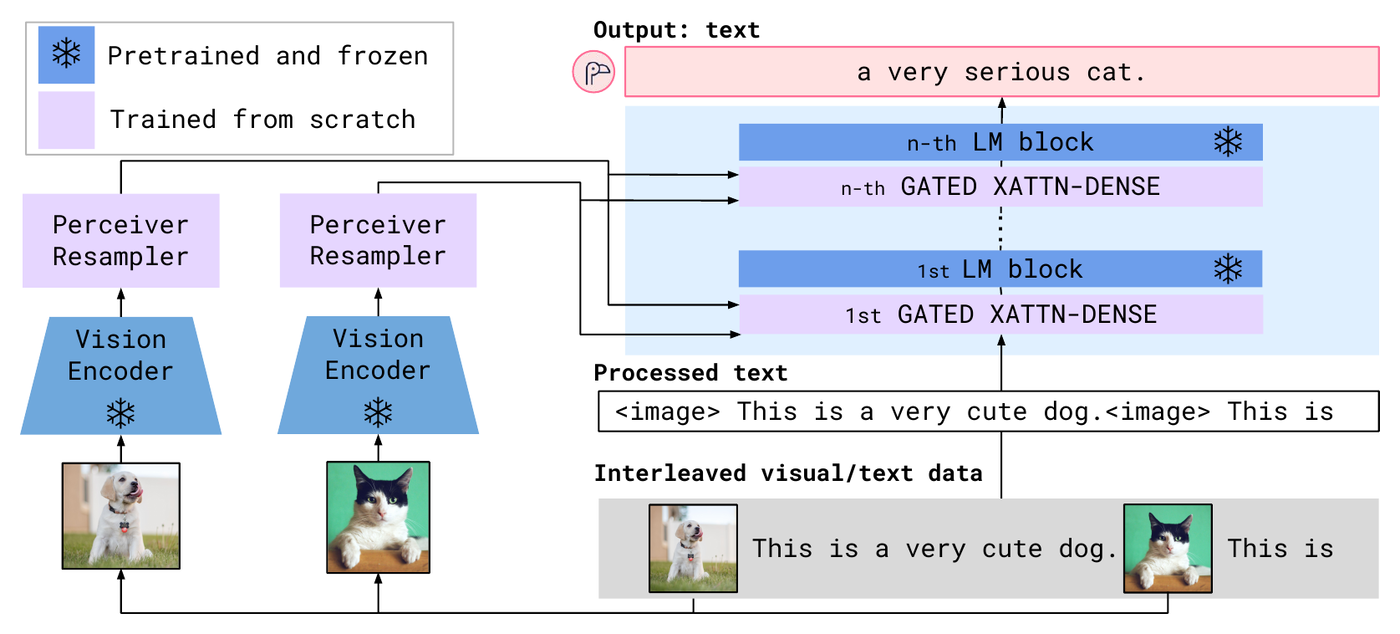
출처: Alayrac et al., Flamingo: a Visual Language Model for Few-Shot Learning, NeurIPS 2022, Figure 3
DeepMind의 Flamingo(2022)는 이미 학습된 LLM을 얼려 둔 채(frozen) 이미지를 볼 수 있게 만든 선구적인 연구입니다.
- 비전 인코더가 이미지를 특징 벡터로 바꿉니다.
- Perceiver Resampler가 이미지 크기와 관계없이 이 특징을 고정된 개수(예: 64개)의 시각 토큰으로 요약합니다. 학습 가능한 질의 벡터 몇 개가 이미지 특징에 어텐션해서 필요한 정보를 뽑아 오는 방식입니다.
- 얼린 LLM의 층 사이사이에 크로스어텐션 층을 새로 끼워 넣습니다. 텍스트 토큰이 Query가 되고 시각 토큰이 Key와 Value가 되어, 글을 읽다가 필요한 순간에 이미지를 참고합니다.
여기서 영리한 장치가 게이트입니다. 새로 끼운 크로스어텐션 층은 가중치가 무작위로 시작해서 처음에는 의미 없는 값을 냅니다. 이 값을 원래 흐름에 그대로 더하면, 잘 학습된 LLM이 받던 입력이 갑자기 망가져 언어 능력부터 흔들립니다. 그래서 새 층의 출력에 볼륨 다이얼을 답니다.
$$y = x + \tanh(\alpha) \cdot \mathrm{CrossAttn}(x,\ \text{이미지})$$x는 원래 LLM의 흐름이고, α는 학습되는 숫자 하나입니다. α를 0으로 시작하면 tanh(0) = 0이라 y = x가 됩니다. 새 층이 무슨 값을 내든 지워지고, LLM은 새 층이 없을 때와 똑같이 동작합니다. 학습이 진행되면서 “이미지를 섞는 편이 답이 좋다"는 신호를 받으면 α가 조금씩 커지고, 그만큼 이미지 정보가 섞여 들어갑니다. 그동안 크로스어텐션 층도 함께 학습되므로, 볼륨이 올라갈 즈음에는 이미 쓸 만한 값을 냅니다. tanh는 결과가 −1과 1 사이라서, α가 커져도 새 층이 원래 흐름을 압도하지 못합니다. 한마디로 새 부품을 꺼진 상태로 달아 원래 모델을 망치지 않고, 쓸모가 생기는 만큼 천천히 켜는 방식입니다.
Flamingo는 이미지 몇 장과 설명을 예시로 보여 주면 새 이미지에 대해 답하는 멀티모달 인컨텍스트 러닝과 이미지에 대한 대화를 보여 주었습니다.
PaLM-E: 이미지도 토큰이다
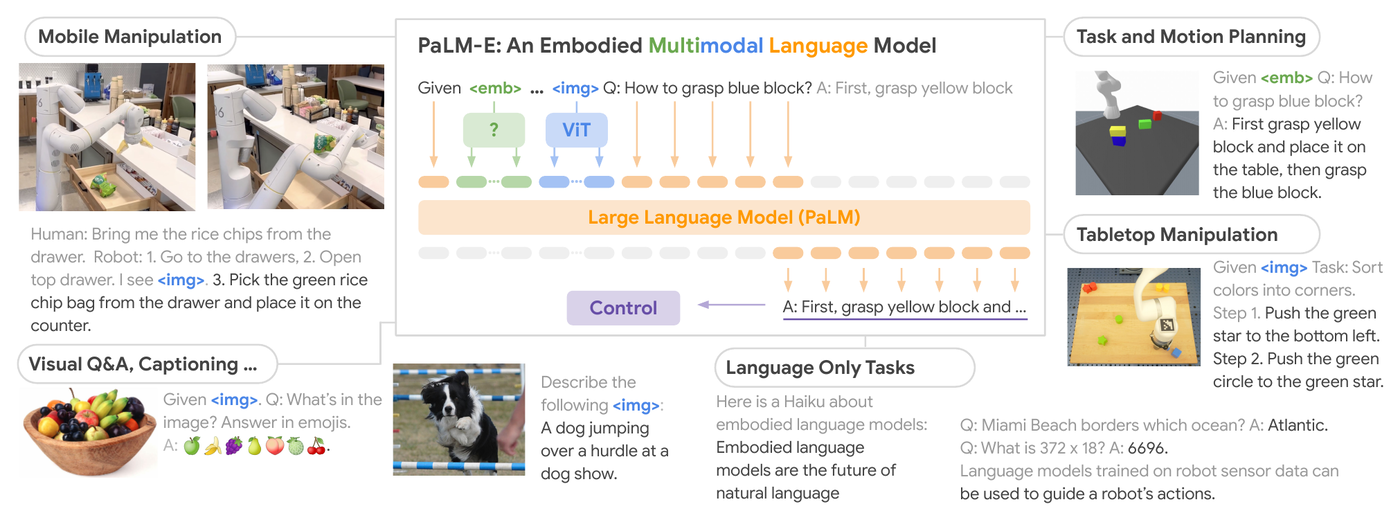
출처: Driess et al., PaLM-E: An Embodied Multimodal Language Model, ICML 2023, Figure 1
구글의 PaLM-E(2023)는 더 직접적인 방법을 택했습니다. 이미지를 비전 인코더(ViT)로 처리한 뒤 LLM의 임베딩과 같은 크기의 벡터로 변환해서, 텍스트 토큰과 같은 줄에 그냥 끼워 넣습니다. “이 <이미지>에서 파란 블록을 집으려면?” 같은 입력이 됩니다. LLM 입장에서는 이미지가 조금 특별한 단어일 뿐입니다.
이 방식은 이미지뿐 아니라 로봇의 관절 상태, 3D 장면 정보 같은 어떤 입력이든 토큰으로 바꾸기만 하면 넣을 수 있다는 장점이 있습니다. 후속 연구인 RT-2는 출력 쪽에도 같은 아이디어를 적용했습니다. 로봇의 움직임 명령을 토큰으로 표현해, 모델이 텍스트를 생성하듯 로봇 제어 신호를 생성합니다. 웹에서 배운 지식(“바나나는 과일이다”)을 로봇 동작(“과일을 집어라”)에 바로 연결할 수 있게 된 것입니다.
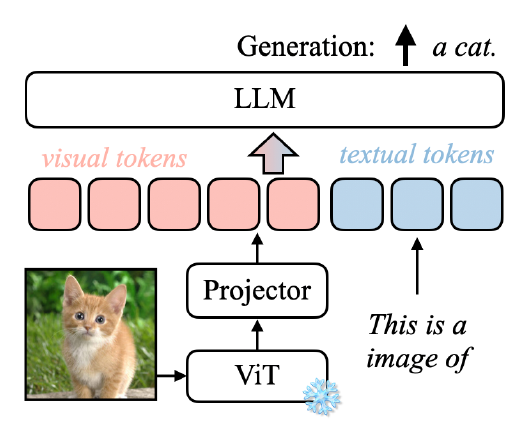
출처: Lin et al., VILA: On Pre-training for Visual Language Models, CVPR 2024, Figure 2
지금 가장 흔한 비전 언어 모델(VLM) 구조는 위 그림처럼 단순합니다. 사전학습된 비전 인코더(ViT) → 작은 변환층(projector) → LLM입니다. LLaVA, Qwen-VL 같은 공개 모델 대부분이 이 형태입니다. 자율주행을 예로 들면, 트럭에서 의자가 날아가는 장면처럼 학습 데이터에 거의 없는 상황도 “고속도로에서 트럭 뒤로 의자가 날아가고 있다, 즉시 멈추고 거리를 둬야 한다"처럼 일반 상식으로 해석할 수 있습니다.
두 방식이 완전히 갈린 것은 아닙니다. Llama 3.2 Vision은 Flamingo처럼 크로스어텐션 층을 붙이는 방식을 썼습니다. 그러나 2026년의 흐름은 한 방향입니다. 텍스트 모델과 비전 모델을 따로 만들지 않고 처음부터 함께 학습하는 네이티브 멀티모달입니다.
- Qwen3.5와 Kimi K2.5는 사전학습 초기부터 이미지 토큰을 텍스트와 섞어 학습했습니다(early fusion). 별도의 비전 어댑터가 없는 하나의 모델입니다. Qwen은 그동안 텍스트 모델과 비전 모델(Qwen-VL)을 따로 냈지만 Qwen3.5부터 하나로 합쳤습니다.
- Gemma 4는 모든 크기가 이미지를 받고, 작은 모델은 음성까지 받습니다. 이미지 한 장에 쓸 토큰 수를 70개에서 1,120개 사이에서 골라 속도와 품질을 조절할 수 있습니다.
- Gemini 같은 상용 모델은 음성과 비디오까지 같은 모델에서 다룹니다.
이미지가 “조금 특별한 단어"라는 PaLM-E의 발상이 이제 기본 설계가 된 셈입니다.
덧붙여: MoE, 크지만 가볍게 돌리기
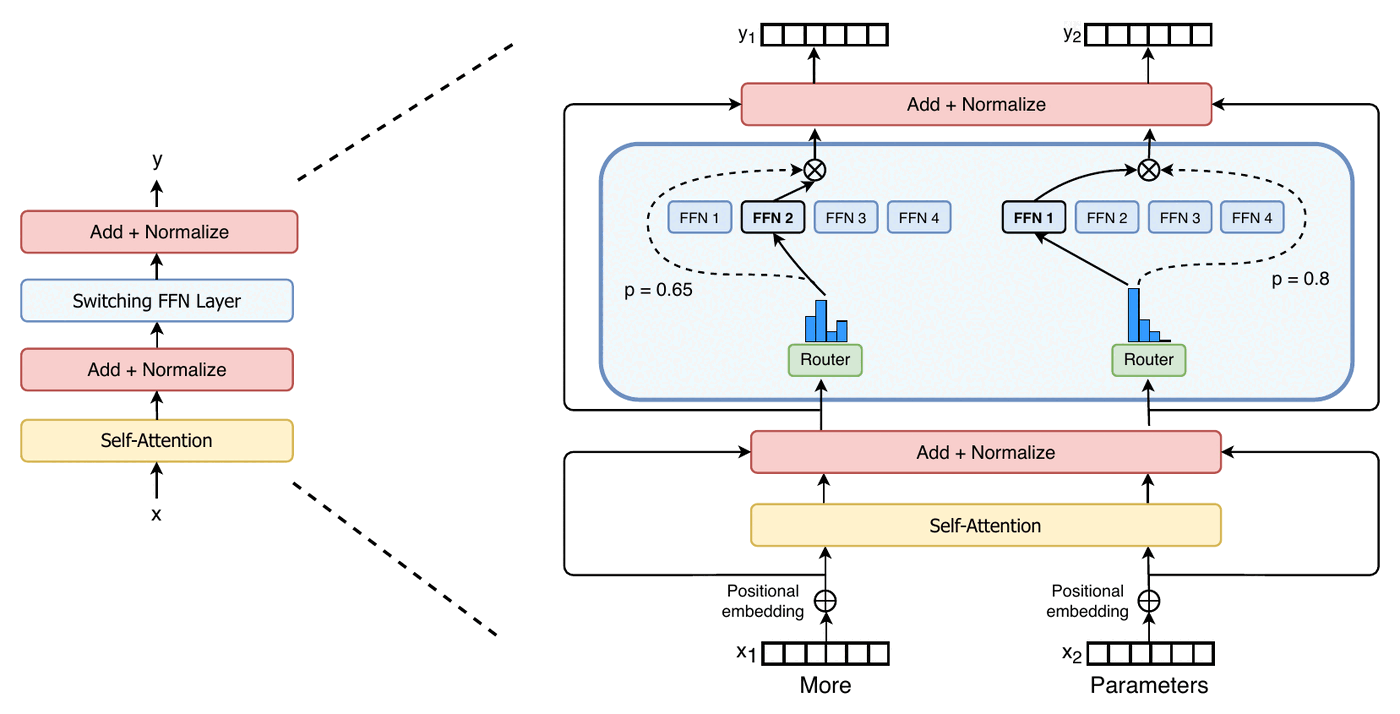
출처: Fedus et al., Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity, JMLR 2022, Figure 2
마지막으로 최신 대형 모델 대부분이 쓰는 구조 하나를 소개합니다. MoE(Mixture-of-Experts, 전문가 혼합) 입니다.
일반 트랜스포머는 모든 토큰이 모든 파라미터를 거칩니다. MoE는 블록 안의 FFN을 여러 개의 “전문가” FFN으로 나누고, 라우터가 토큰마다 그중 몇 개만 골라 보냅니다. Switch Transformer는 1개, Mixtral은 2개, DeepSeek-V3는 8개를 고릅니다. 전체 파라미터는 아주 크지만 토큰 하나를 처리할 때 실제로 쓰는 파라미터는 일부라서, 모델의 지식 용량은 크게 키우면서 토큰당 계산량은 작게 유지할 수 있습니다.
이름 때문에 “수학 전문가”, “코딩 전문가”, “의학 전문가"가 따로 있다고 오해하기 쉽지만 그렇지 않습니다. 전문가는 사람이 분야를 나눠 맡긴 것이 아니라, 라우터와 함께 학습되면서 저절로 역할이 나뉜 FFN일 뿐입니다. Mixtral 논문은 arXiv 논문, 생물학 초록, 철학 문서를 넣고 어느 전문가가 선택되는지 쟀는데, 세 분야의 분포가 거의 같았습니다. 오히려 파이썬 코드의
self나 들여쓰기, 영어의 “Question” 같은 특정 토큰이 같은 전문가로 가는 식으로, 주제보다는 문법이나 형태 수준의 패턴이 보였습니다. 구글의 ST-MoE 연구에서도 구두점, 동사, 고유명사, 숫자를 주로 맡는 전문가는 있었지만, 여러 언어를 섞어 학습한 모델에서도 전문가가 언어별로 나뉘지는 않았습니다. 게다가 전문가는 층마다, 토큰마다 따로 고르기 때문에 한 문장 안에서도 단어마다 다른 전문가를 거칩니다. MoE의 “전문가"는 분야 담당자라기보다 토큰 단위로 일을 나눠 맡는 FFN 조각에 가깝습니다.
| 모델 | 전체 파라미터 | 토큰당 활성 파라미터 |
|---|---|---|
| Mixtral 8x7B | 약 470억 | 약 130억 |
| DeepSeek-V3 | 6,710억 | 370억 |
| Llama 4 Maverick | 약 4,000억 | 170억 |
| Qwen3.5 | 3,970억 | 170억 |
| DeepSeek-V4-Pro | 1조 6,000억 | 490억 |
2026년 현재 대형 공개 모델은 거의 예외 없이 MoE입니다. 전문가 수는 늘리고 하나하나는 작게 만드는 방향으로 가고 있어서, Qwen3.5는 전문가가 512개입니다.
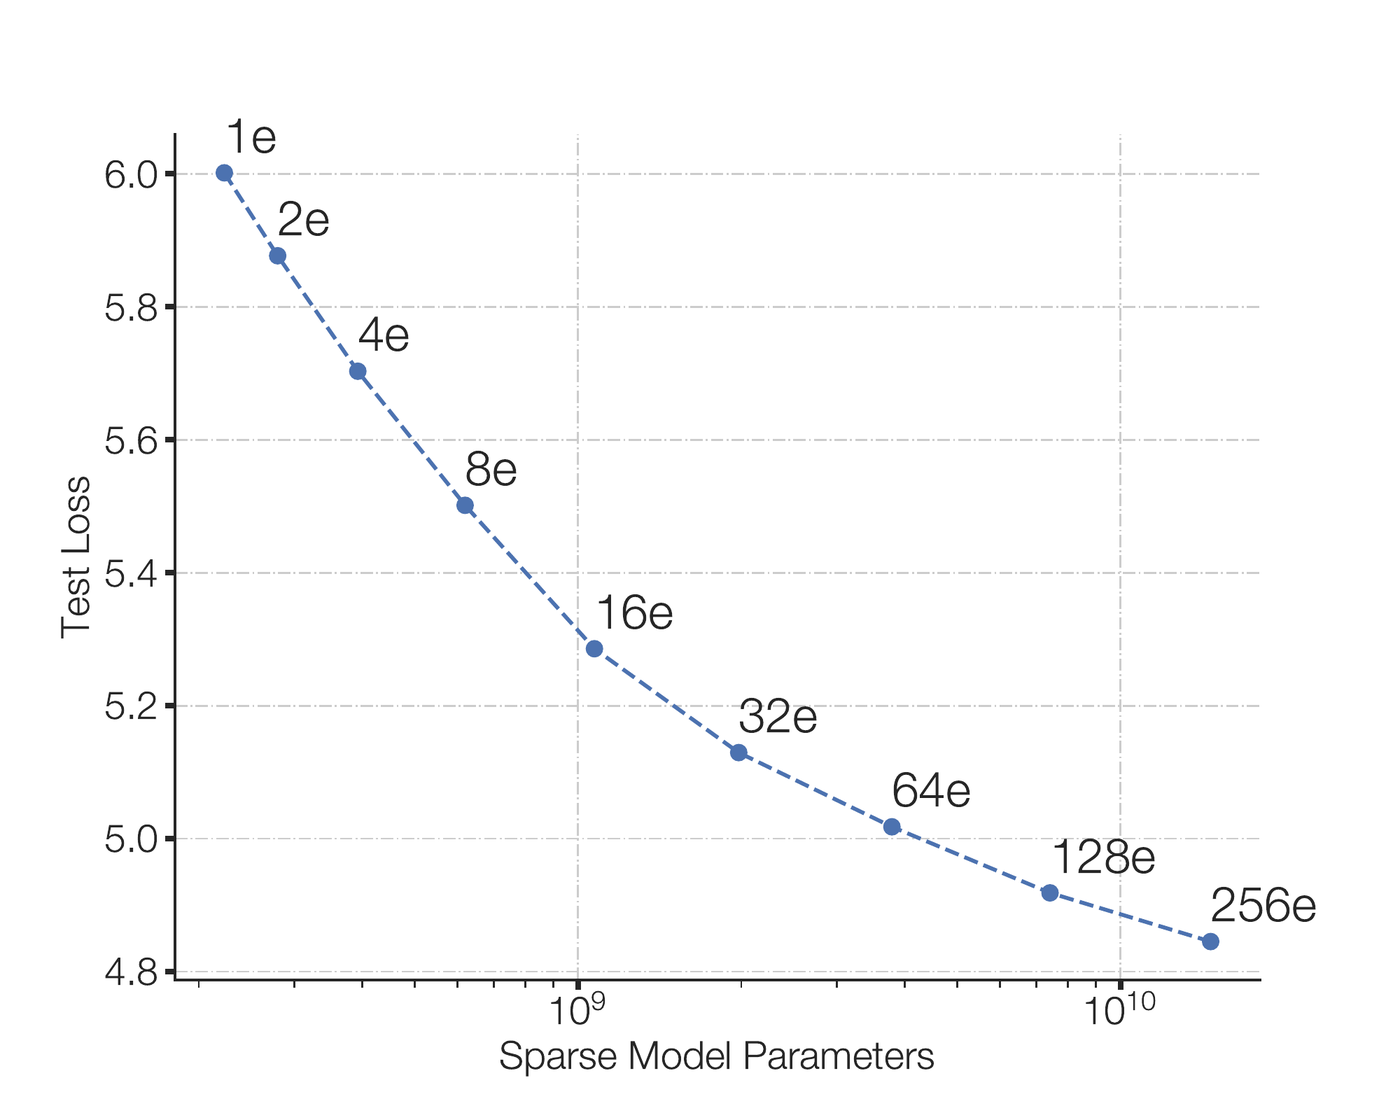
출처: Fedus et al., Switch Transformers, JMLR 2022, Figure 4 (왼쪽)
전문가를 늘리는 이유가 이 그림에 있습니다. 전문가가 1개면 보통의 T5-Base이고, 256개면 전체 파라미터는 수십 배지만 토큰 하나가 거치는 계산은 같습니다. 그런데도 손실은 전문가 수를 두 배로 늘릴 때마다 꾸준히 내려갑니다. 계산을 더 쓰지 않고도 모델을 “더 똑똑하게” 만들 수 있다는 뜻입니다.
대신 계산량이 작아도 전체 파라미터는 메모리에 올려 둬야 하므로 GPU 메모리는 많이 필요합니다. 특정 전문가에게 토큰이 몰리지 않게 라우터를 학습시키는 것도 MoE의 까다로운 부분입니다.
정리
- 트랜스포머 이전: RNN은 순서대로 읽느라 느리고 먼 관계를 잊었고, CNN은 빠르지만 시야가 좁았습니다.
- 트랜스포머: 셀프 어텐션으로 모든 토큰이 서로를 한 번에 봅니다. 먼 관계를 바로 연결하고, GPU에서 병렬로 학습할 수 있습니다.
- 디자인 변형: 대부분 “더 길게, 더 싸게"를 위한 개선입니다. 디코더만 쓰는 구조, RoPE, KV 캐시와 GQA, SwiGLU가 표준 조합이 되었습니다.
- LLM: 크게 키우니 예시 몇 개만으로 새 과제를 푸는 인컨텍스트 러닝이 생겼습니다. 추론 비용을 생각하면 작은 모델을 오래 학습하는 것이 유리하고, 최근에는 답할 때 더 오래 생각하게 하는 방향이 더해졌습니다.
- 멀티모달: 이미지를 토큰으로 바꿔 LLM에 넣는 방식이 주류가 되었고, 2026년에는 처음부터 텍스트와 이미지를 함께 학습하는 네이티브 멀티모달이 기본이 되었습니다.
관련 글
- 경량화 시리즈 #2: 뉴럴넷 양자화: 커진 LLM을 작은 GPU에 올리는 방법.
- 경량화 시리즈 #6, 지식 증류: 큰 모델의 지식을 작은 모델로 옮기는 방법.
- 생성하지 말고 판단하라: 인코더 전략: BERT 계열 인코더를 서비스에 쓴 기록.
참고
- MIT 6.5940 Lecture 12: Transformer and LLM (Song Han). 이 글의 뼈대이자 KV 캐시 그래프의 출처입니다.
- Bahdanau et al., Neural Machine Translation by Jointly Learning to Align and Translate, ICLR 2015
- Vaswani et al., Attention Is All You Need, NeurIPS 2017
- Clark et al., What Does BERT Look At? An Analysis of BERT’s Attention, BlackboxNLP 2019
- Voita et al., Analyzing Multi-Head Self-Attention: Specialized Heads Do the Heavy Lifting, the Rest Can Be Pruned, ACL 2019
- Devlin et al., BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding, NAACL 2019
- Weller et al., Seq vs Seq: An Open Suite of Paired Encoders and Decoders (Ettin), ICLR 2026
- Gisserot-Boukhlef et al., Should We Still Pretrain Encoders with Masked Language Modeling?, ICLR 2026
- BehnamGhader et al., LLM2Vec: Large Language Models Are Secretly Powerful Text Encoders, COLM 2024
- Raffel et al., Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer (T5), JMLR 2020
- Su et al., RoFormer: Enhanced Transformer with Rotary Position Embedding, 2021
- Chen et al., Extending Context Window of Large Language Models via Positional Interpolation, 2023
- Shazeer, Fast Transformer Decoding: One Write-Head is All You Need (MQA), 2019
- Ainslie et al., GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints, EMNLP 2023
- DeepSeek-AI, DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model (MLA), 2024
- Shazeer, GLU Variants Improve Transformer, 2020
- Brown et al., Language Models are Few-Shot Learners (GPT-3), NeurIPS 2020
- Wei et al., Emergent Abilities of Large Language Models, TMLR 2022
- Schaeffer et al., Are Emergent Abilities of Large Language Models a Mirage?, NeurIPS 2023
- Touvron et al., LLaMA / Llama 2, 2023
- Llama Team, The Llama 3 Herd of Models, 2024
- Jiang et al., Mistral 7B, 2023
- Hoffmann et al., Training Compute-Optimal Large Language Models (Chinchilla), NeurIPS 2022
- DeepSeek-AI, DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning, 2025
- Alayrac et al., Flamingo: a Visual Language Model for Few-Shot Learning, NeurIPS 2022
- Driess et al., PaLM-E: An Embodied Multimodal Language Model, ICML 2023
- Brohan et al., RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control, 2023
- Lin et al., VILA: On Pre-training for Visual Language Models, CVPR 2024
- Liu et al., Visual Instruction Tuning (LLaVA), NeurIPS 2023
- Fedus et al., Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity, JMLR 2022
- Zoph et al., ST-MoE: Designing Stable and Transferable Sparse Expert Models, 2022
- Jiang et al., Mixtral of Experts, 2024
- DeepSeek-AI, DeepSeek-V3 Technical Report, 2024
- Maxime Labonne, Qwen3.5: Nobody Agrees on Attention Anymore, 2026
- Sebastian Raschka, A Dream of Spring for Open-Weight LLMs: 10 Architectures from Jan–Feb 2026, 2026
- DeepSeek-AI, DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence, 2026
- Google, Gemma 4 Launch Announcement, 2026
- The Decoder, Inception launches Mercury 2, the first diffusion-based language reasoning model, 2026