요약
저비용 판정 모델 JEV의 프롬프트를 분류기 핏팅하듯 튜닝해 학습 라벨에서 문제 행을 골라낸 방법을 정리한다. 프롬프트를 감으로 고칠 때 생기는 문제, 홀드아웃·회귀 재채점·정밀도-재현율로 경계값을 정하는 절차, 그리고 언제 멈춰야 하는지를 다룬다.
어떤 문제인가
큰 모델로 학습 라벨을 만들어 작은 모델을 fine-tuning하는 일은 흔하다. 그런데 교사 모델이 만든 라벨에는 체계적인 결함이 섞이기 마련이다. 입력에 있던 이름, 수치, 기한 같은 구체적인 값을 “조건을 달았다”, “담당자를 정했다” 같은 범주어로 뭉개는 식이다. 학생 모델은 그 결함까지 충실히 배운다. 그래서 라벨을 쓰기 전에 어떤 행이 기준을 어기는지 골라내야 한다.
문제는 수천 행을 누가 읽느냐다. 사람이 다 읽을 수는 없고, Opus 같은 모델에게 맡기면 한 바퀴에 수백 달러가 들고 기준을 조금 고칠 때마다 또 그만큼이다. 더 싼 판정기가 필요하다.
JEV라는 판정 모델
JEV는 TypeSafe AI의 저비용 판정 모델이다(공식 문서). 글을 생성하는 게 아니라 “이 상태를 이 기준으로 보면 몇 점인가"만 답한다. 요청은 이런 모양이다(내용은 지어낸 것, 긴 부분은 줄였다).
// 요청
{
  "model": "jev-1.13.0",
  "state": {
    "input": "## 회의 기록\n김 팀장: 서버 교체는 11월 14일까지 끝내 주세요. 예산은 320만 원 한도이고, 벤더는 지난번 그 회사 말고 두 군데 더 견적 받아서 비교하세요. 담당은 박 대리.\n...생략...",
    "output": "{\"decisions\":\"서버 교체 일정과 예산을 정했고, 벤더 견적을 추가로 받기로 했다. 담당자를 지정했다.\", ...생략...}"
  },
  "questions": {
    "specifics": {
      "type": "score",
      "instructions": "...생략... First list the concrete values stated in the input (dates, amounts, counts, names, titles, conditions) ...생략... A value is retained only if it appears as stated; a category word in place of the value ('set a budget', 'assigned someone') is a miss.",
      "criteria": [
        "Two or more concrete values are missing or replaced by category words, or recorded with the wrong value.",
        "One concrete value is missing or abstracted away.",
        "All concrete values are present but one is vaguer than the source.",
        "All concrete values present with negligible loss of specificity.",
        "Every concrete value is recorded as stated, or the input has none."
      ]
    }
  }
}
// 응답
{
  "answers": {
    "specifics": {
      "score": 1.3,
      "probabilities": { "0": 0.21, "1": 0.43, "2": 0.24, "3": 0.09, "4": 0.03 }
    }
  }
}
이 출력은 “일정과 예산을 정했다"고만 써서 기한(11월 14일), 금액(320만 원), 조건(견적 두 군데 더), 담당자(박 대리)를 다 뭉갰다. JEV는 다섯 단계에 대한 확률 분포를 주고, 점수는 그 기댓값이다(0.21×0 + 0.43×1 + … = 1.3).
여기서 알아 두면 좋은 것 세 가지.
- 싸다. 수천 행을 전부 채점해도 1달러가 안 되고 몇 분이면 끝난다.
- 같은 입력이면 같은 점수가 나온다(재채점 상관 0.99). 그래서 한 번 채점한 행은 캐시해 두고 바뀐 것만 다시 채점하면 된다.
- 모델 가중치는 못 건드린다. 우리가 바꿀 수 있는 건
instructions,criteria, 그리고 점수를 “문제/정상"으로 가르는 경계값뿐이다.
나이브한 접근
판정 모델이 있으니 프롬프트만 쓰면 된다고 생각하면 보통 이렇게 한다. 모델 출력 평가에 쓰던 질문을 그대로 라벨에 넣고, 결과를 몇 건 훑어보다 이상한 게 보이면 지시문에 문장을 덧붙이고, 점수 낮은 행 몇 개가 진짜 문제인 걸 확인하고, 중간 점수 아래를 문제로 보기로 하고 전체에 돌린다.
각 단계가 이렇게 깨진다.
- 모델 출력 평가용 질문은 출력에 맞춘 것이라 라벨에 대면 너무 짜게 준다. 채점 대상이 다르면 다른 분류기다.
- 보이는 대로 덧붙인 문장은 그 샘플만 맞추고 다음 샘플에서 깨진다. 깨진 걸 알아챌 장치도 없다.
- 점수 낮은 행은 판정기가 확신하는 구간이라 거의 안 틀린다. 봐야 할 건 경계 근처다.
- JEV는 정상 라벨에도 만점을 잘 안 준다. 중간값에서 자르면 멀쩡한 행이 대거 걸린다.
- 지시문을 바꾸면 점수 분포가 통째로 움직인다. 전후 비율 차이는 개선이 아니다.
전부 분류기를 다룰 때 이미 이름이 있는 문제들이다. 분포 이동, 과적합, 검증 편향, 임계값, 지표 혼동. 그래서 접근을 바꿨다.
핵심: 프롬프트를 분류기의 파라미터로 보기
JEV에 질문 하나를 넣으면 그건 사실상 분류기 하나다. 라벨을 넣으면 점수가 나오고, 경계값을 정하면 “문제/정상"으로 나뉜다. 분류기라면 파라미터가 있어야 하는데, 여기서는 그게 프롬프트다. instructions는 “상태에서 뭘 볼지"를, criteria 문장들은 “클래스가 각각 뭔지"를 정한다.
그렇다면 프롬프트를 고치는 일은 분류기를 다시 핏팅하는 일이고, 분류기를 핏팅할 때 당연히 하는 것들(학습 데이터, 홀드아웃, 과적합 방지, 회귀 테스트, 임계값 고르기)을 그대로 해야 한다.
튜닝 한 바퀴
라운드 하나는 이렇게 돈다. 풀 크기를 N, 검수 건수를 k라고 하자.
- 아직 안 쓴 샘플 N건을 뽑아서 지금 프롬프트로 JEV 채점.
- 점수 분포에서 고르게 k건을 뽑는다(낮은 점수, 중간, 높은 점수가 다 들어가게).
- 같은 k건을 Opus가 JEV 점수를 모른 채 독립적으로 판정한다. 결론부터 내지 말고, 먼저 “이 라벨에 있어야 할 구체값 목록"을 적은 뒤 라벨과 하나씩 대조해서 통과/경고/실패를 매기게 한다.
- JEV 판정과 Opus 판정을 비교해서 어디서 어긋나는지 본다.
- 어긋난 이유가 프롬프트의 어떤 규칙 때문인지 찾아 고친다. 다음 라운드로.
N은 JEV 비용이 거의 안 드니 크게 잡아도 되고(우리는 100), k는 Opus 비용과 사람이 불일치를 읽는 시간이 들어가니 작게 잡는다(우리는 5). k가 작은 대신 라운드를 여러 번 돌리고, 검수한 사례는 버리지 않고 누적한다. 기준 하나를 튜닝하는 데 보통 6~12라운드, 한두 시간이 든다.
여기서 “정답"은 사람이 아니라 Opus다. 싼 분류기를 비싼 모델의 판단에 맞추는 것이다. 사람은 뒤에 따로 나온다.
언제 멈추나
멈추는 경우는 둘이고, 기준이 다르다.
성공으로 멈춤. 프롬프트를 고정한 뒤 새로 뽑은 홀드아웃에서 이진(문제/정상) 일치율이 목표(우리는 90%) 근처이고, 그 하한을 신뢰구간으로 말할 수 있을 때. 고정 전에 검수한 사례는 프롬프트를 거기에 맞춰 고친 것이라 홀드아웃이 아니다. 고정 후 건수는 k=5 한 라운드로는 부족하다. 건마다 일치/불일치가 베르누이 시행이니 몇 건이 필요한지는 이항 비율의 Wilson 신뢰구간으로 계산할 수 있다. 관측 일치율 90%에서 “하한이 L 이상"을 95% 신뢰로 말하려면 이만큼 필요하다.
| 보장하고 싶은 하한 L | 필요 건수 | 라운드 수 (k=3) | k=5 | k=10 | k=20 |
|---|---|---|---|---|---|
| 75% | 33 | 11 | 7 | 4 | 2 |
| 80% | 62 | 21 | 13 | 7 | 4 |
| 85% | 196 | 66 | 40 | 20 | 10 |
목표를 빠듯하게 잡을수록(관측값과 하한의 차이가 작을수록) 건수가 급격히 는다. 우리처럼 k=5면 하한 80%를 보장하는 데 고정 후 13라운드가 필요하다. 건수를 미리 정하지 않고 건마다 판단해서 더 일찍 멈추고 싶으면 Wald의 순차 확률비 검정(SPRT)을 쓴다. 건마다 로그 우도비를 누적해 상한에 닿으면 성공, 하한에 닿으면 실패로 멈추고, 평균적으로 고정 건수보다 적게 든다.
실패로 멈춤. 2~3라운드 연속 홀드아웃 일치율이 안 움직이거나, 한 규칙을 넣으면 다른 사례가 깨지는 식으로 누적 재채점이 제자리를 돌 때. 이건 프롬프트 문구로 풀리는 상태가 아니라 기준 정의가 틀렸을 가능성이 크다. 튜닝을 멈추고 정의로 돌아간다(뒤의 “사람은 어디에 있나”). 정의를 바꾸면 이전 검수 판정도 새 정의로 다시 라벨링하고, 홀드아웃 건수는 0부터 다시 센다.
지켜야 하는 규칙들
매 라운드 처음 보는 샘플로
분류기의 홀드아웃이다. 같은 골드셋 몇십 건을 두고 계속 고치면 그 몇십 건에 딱 맞는 프롬프트가 나오고, 그게 다른 데서도 맞는지는 알 수 없다. 매 라운드 새 샘플을 뽑으면 라운드 n의 일치율이 곧 버전 n−1의 홀드아웃 성능이다. 규칙 하나를 넣었을 뿐인데 홀드아웃 일치율이 떨어지는 버전은 실제로 나온다. 같은 골드셋만 보고 있으면 이게 안 보인다.
반복되는 패턴만 규칙으로
과적합 방지다. 검수 5건 중 하나가 호칭 ‘대리’를 놓쳤다고 “‘대리’를 세라"를 넣으면 그 샘플은 맞지만 다음 라운드에서 깨진다. 다른 라운드에서도 호칭·직책 누락이 반복될 때 “호칭·직책은 보존 대상이다"처럼 일반 규칙으로 넣는다. 지시문에 넣는 예시도 실제 샘플과 다른 값으로 쓴다. 프롬프트는 자연어라 특정 사례를 넣고 싶은 유혹이 꽤 크다.
예전에 검수한 것도 다시 채점
회귀 테스트다. 프롬프트 수정은 국소적이지 않다. 예를 들어 “그 자리에서 끝나는 요청·행동은 보존 대상이 아니다” 같은 규칙 하나를 넣으면, 그 규칙과 무관해 보이던 이전 라운드의 사례가 뒤집힐 수 있다. 그래서 새 버전을 만들 때마다 지금까지 검수한 사례 전부를 다시 채점해서 앞의 것이 깨지지 않았는지 본다.
버전 비교는 같은 검수 사례로만
위의 규칙처럼 “뭘 셀지"를 바꾸는 수정을 넣으면 풀 N건의 “통과” 비율이 몇 배로 뛰기도 한다. 좋아진 것 같지만 아니다. 세는 대상이 줄어서 점수 분포가 통째로 이동한 것이다. 정의를 바꾸면 분포가 바뀌니, 버전은 같은 검수 사례에 대한 일치율로만 비교한다. 반대 방향도 있다. 통과율이 몇 %p 떨어져서 열어 보면 실제 사례는 거의 다 멀쩡하고 JEV 쪽이 틀린 경우다. 점수가 크게 움직이면 어느 쪽이든 실제 사례를 열어 봐야 한다.
경계값은 정밀도·재현율로 정한다
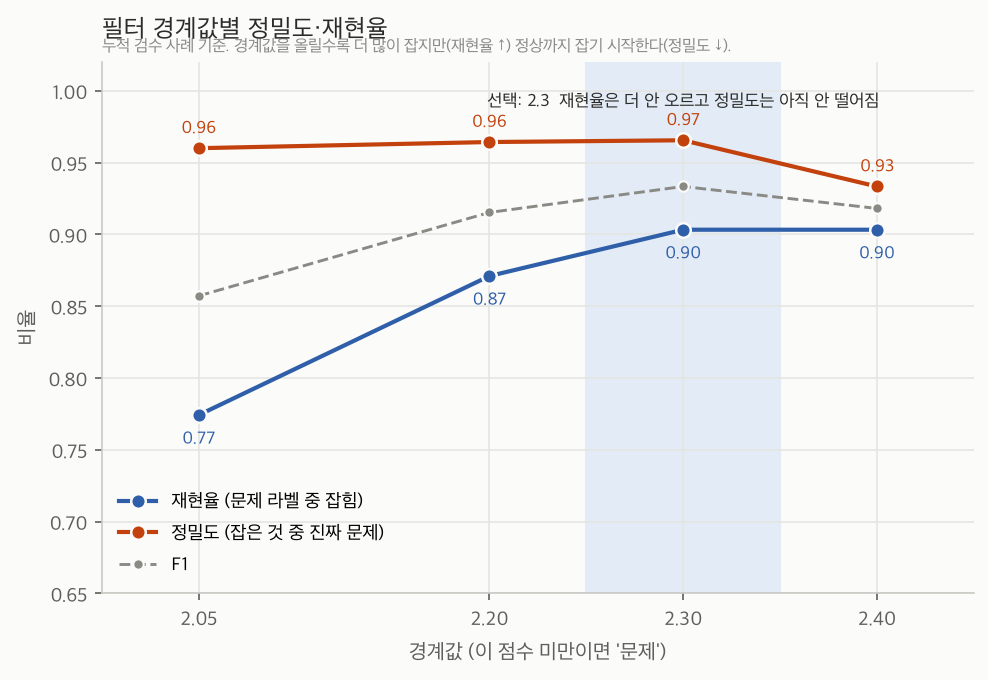
점수를 어디서 잘라 “문제"로 볼지는 분류기의 임계값을 고르는 일과 같다. 중간값(2.5)이 아니라 검수 사례로 정한다. 누적 검수 사례를 Opus가 문제라고 한 것과 정상이라고 한 것으로 나누고, 경계값을 하나씩 올려 본다.
| 경계 (미만이면 문제) | 재현율 | 정밀도 |
|---|---|---|
| 2.05 | 77% | 96% |
| 2.2 | 87% | 96% |
| 2.3 | 90% | 97% |
| 2.4 | 90% | 93% |
경계값을 올릴수록 더 많이 잡지만(재현율 ↑) 어느 지점부터 정상까지 잡기 시작한다(정밀도 ↓). 2.3에서 재현율이 더 안 오르고 정밀도는 아직 안 떨어져서 거기로 정한다. 흔히 보는 스윗스팟 그림 그대로다.
이게 되려면 경계 근처 샘플이 검수에 들어 있어야 한다. 점수가 제일 낮은 것들만 검수하면 당연히 다 맞으니 정밀도만 좋아 보이고, 놓친 건 안 보이니 재현율은 잴 수가 없다. 그래서 검수 샘플은 점수 분포 전체에서 고르게 뽑되, 경계값 근처가 반드시 포함되게 한다.
사람은 어디에 있나
Opus가 정답이면 사람은 필요 없나? 그렇지 않다. 기준 정의 자체가 틀려 있으면 Opus 검수자도 JEV와 같은 정의를 받으니 둘이 같은 방향으로 틀리고, 일치율은 멀쩡하다. 실제로 겪은 예는, 출력이 읽히는 시점에는 이미 쓸모없어질 정보를 “꼭 남겨야 할 값"으로 치고 있었던 경우다. 지표에는 안 보였고, 사람이 결과 예시를 읽다가 “왜 곧 사라질 정보를 열심히 살리고 있지?“라고 한 뒤에야 드러났다. 정의를 고치고 이전 검수 판정도 다시 라벨링해야 풀린다.
그래서 사람은 판정기와 검수자 바깥에서, 기준 정의와 결과 표본 몇 건만 본다. 수천 행을 읽는 대신 한 기준당 예시 열 몇 건이다.
마무리
JEV 같은 판정 모델을 쓰면 프롬프트가 곧 분류기다. 그러면 “프롬프트를 잘 쓴다"는 막연한 일이 “분류기를 핏팅한다"는 익숙한 일이 되고, 홀드아웃, 과적합 방지, 회귀 테스트, 임계값 선택을 그대로 가져다 쓰면 된다. 판정이 1달러도 안 되고 몇 분이라 이걸 하루에 수십 번 돌릴 수 있다는 게 전부를 가능하게 했다.
반대로 익숙한 함정도 그대로 따라온다. 같은 골드셋만 보면 과적합하고, 분포 이동을 개선으로 착각하고, 정의가 틀리면 분류기와 검수자가 같이 틀린다. 마지막 건 지표로 안 보이니, 사람이 가끔 예시를 읽어야 한다.
경계값 아래로 걸러진 행을 Opus로 고친 이야기는 별도 글로.
참고
- TypeSafe AI. Jev 공식 문서. 이 글에서 쓴
score질문의instructions·criteria·probabilities는 Score 프리미티브 페이지에 있다. - Wilson, E. B. (1927). Probable inference, the law of succession, and statistical inference. Journal of the American Statistical Association, 22(158), 209–212.
- Wald, A. (1945). Sequential tests of statistical hypotheses. The Annals of Mathematical Statistics, 16(2), 117–186.