배경
Jev가 던진 질문
2026년 9월 15일, TypeSafe AI가 Jev를 공개했습니다. 스스로를 “System One Model"이라 부르는 이 모델은 텍스트를 한 토큰씩 생성하지 않습니다. 대화 같은 상태와 “이 메시지는 위험한가(yes/no)”, “다음 행동은 A/B/C 중 무엇인가” 같은 타입이 정해진 질문을 받아서, 답과 확률을 한 번에 돌려줍니다. 회사 측 발표로는 프론티어 LLM보다 수십 배 빠르고, 출력 토큰은 무료입니다.
업계가 들썩인 이유는 성능 숫자보다 문제 설정 때문입니다. 지금까지 많은 팀이 “분류 하나 하려고 LLM에 프롬프트를 넣고, 나온 문장을 파싱하는” 방식으로 판정을 처리해 왔습니다. Jev는 그 판정 작업이 애초에 생성 모델의 일이 아니라는 점을 정면으로 짚었습니다.
며칠 만에 쏟아진 따라잡기 모델들
반응은 빨랐습니다. 발표 며칠 만에 Laya, Von, Kev, Decider, Bespoke Nimble 같은 오픈 모델이 줄줄이 나왔고, 일주일도 안 돼 이를 비교하는 벤치마크까지 등장했습니다. 구현 방식은 크게 세 갈래입니다.
- 작은 인코더 + 판정 헤드: ModernBERT 같은 수억 파라미터 인코더가 상태와 질문을 한 번에 읽고, 작은 헤드가 선택지마다 점수를 매깁니다.
- 기존 LLM의 logit 읽기: 선택지를 A/B/C로 적어 두고, 다음 토큰 확률을 그대로 답의 분포로 씁니다.
- NLI 활용: 선택지마다 “이 문장이 참인가"를 묻고 확률을 정규화합니다.
이렇게 빨리 따라잡을 수 있었던 이유는 간단합니다. 판정에 필요한 지식은 이미 큰 LLM 안에 있기 때문입니다. 남은 문제는 그 지식을 어떻게 작고 빠른 모델로 옮기느냐이고, 이건 정확히 지식 증류(Knowledge Distillation)가 다루는 주제입니다.
같은 “증류”, 다른 의미
그런데 요즘 “증류"라는 말은 원래 의미보다 훨씬 넓게 쓰입니다. 둘을 구분해 두면 이 글을 읽기가 쉬워집니다.
| Hinton의 증류 (2015) | 요즘 흔히 말하는 “증류” | |
|---|---|---|
| 전달하는 것 | teacher의 확률 분포 (soft label) | teacher가 만든 출력 결과물 (문장, 라벨, 추론 과정) |
| teacher 접근 | logit에 접근할 수 있어야 함 | API로 응답만 받아도 됨 |
| 학습 방식 | KL divergence로 분포를 맞춤 | 생성된 데이터로 일반 SFT |
| 핵심 개념 | temperature, dark knowledge | 합성 데이터(synthetic data), 데이터 생성 파이프라인 |
| 예시 | DistilBERT, MobileBERT | “R1-Distill"류 모델, 큰 LLM이 라벨링한 데이터로 학습한 분류기 |
엄밀히 말하면 오른쪽은 sequence-level KD, 또는 그냥 “큰 모델로 만든 데이터로 학습하기"에 가깝습니다. 분포에 담긴 정보(이게 왜 헷갈리는지)는 버리고 정답만 가져오는 셈입니다. 그래도 간단하고 teacher의 내부에 접근할 필요가 없어서, 현업에서는 이쪽이 훨씬 많이 쓰입니다.
판정 모델은 두 세계가 다시 만나는 지점입니다. Jev가 강조하는 calibrated 확률은 결국 “답만이 아니라 얼마나 확신하는지까지” 옮기겠다는 뜻이고, 이건 Hinton이 말한 soft label의 문제의식 그대로입니다. 이 글은 그래서 원래 의미의 KD부터 차근차근 짚고, 마지막에 다시 판정 모델과 캐릭터 채팅 서비스로 돌아옵니다. 그 전에, 애초에 작은 모델은 왜 배우기 어려운지부터 봅니다.
왜 작은 모델은 배우기 어려운가
모델은 작을수록 비용이 줄어들고, 레이턴시는 짧아지고 쓰루풋은 올라갈 가능성이 높습니다. 그래서 같은 문제를 작은 모델로 풀 수 있다면 그게 가장 좋습니다. 문제는 모델을 줄이면 같은 데이터와 같은 레시피로 학습해도 성능이 기대만큼 나오지 않는다는 점입니다. 이 현상을 선명하게 보여주는 연구가 NetAug(Network Augmentation for Tiny Deep Learning, Cai et al., ICLR 2022)입니다.
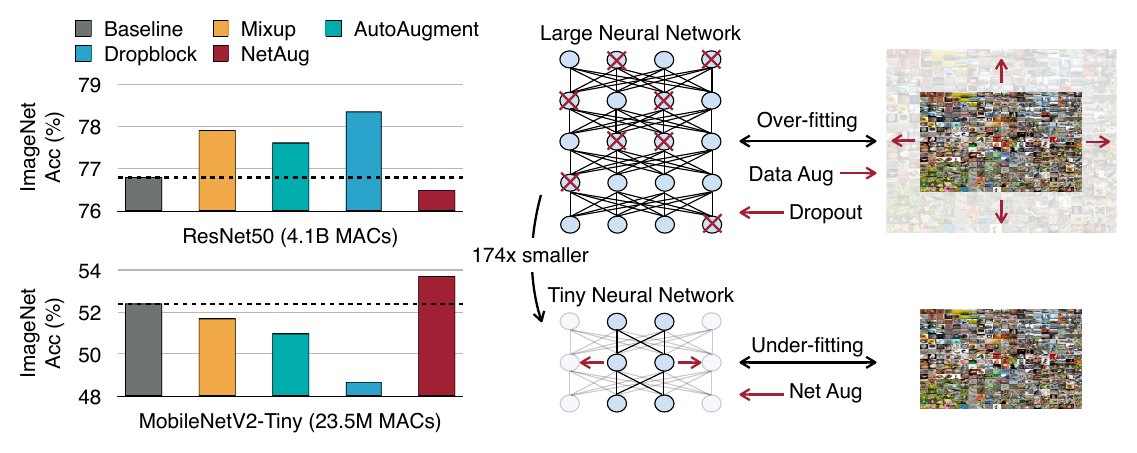
출처: Cai et al., Network Augmentation for Tiny Deep Learning, ICLR 2022, Figure 1
큰 모델에 좋은 regularization이 작은 모델에는 해롭다
왼쪽 그래프는 ImageNet 학습에 흔히 쓰는 regularization 기법들을 두 모델에 적용한 결과입니다.
| 기법 | ResNet50 (4.1B MACs) | MobileNetV2-Tiny (23.5M MACs) |
|---|---|---|
| Baseline | 76.8 | 52.4 |
| Mixup | 77.9 (+1.1) | 51.7 (−0.7) |
| AutoAugment | 77.6 (+0.8) | 51.0 (−1.4) |
| DropBlock | 78.4 (+1.6) | 48.7 (−3.7) |
데이터 증강(Mixup, AutoAugment)과 dropout 계열(DropBlock)은 큰 모델의 정확도를 올리지만, 174배 작은 모델에서는 모두 정확도를 떨어뜨립니다.
작은 모델의 문제는 overfit이 아니라 underfit이다
이유는 오른쪽 그림에 있습니다. 큰 모델은 용량이 남아서 학습 데이터를 외워 버리기 쉽습니다(over-fitting). 그래서 데이터나 네트워크에 노이즈를 넣어 일부러 학습을 어렵게 만드는 regularization이 통합니다.
작은 모델은 반대입니다. 학습 데이터조차 다 소화하지 못합니다(under-fitting). 이미 버거운 모델에 노이즈까지 얹으면 더 못 배우게 됩니다. 논문의 표현을 빌리면, 작은 모델에 필요한 건 학습 중의 노이즈가 아니라 용량입니다.
그렇다면 작은 모델을 더 잘 가르치는 방향은 두 가지입니다. 하나는 학습하는 동안만 용량을 빌려주는 것이고(뒤에서 다룰 NetAug), 다른 하나는 같은 데이터로 가르치더라도 더 정보가 많은 정답을 주는 것입니다. 후자가 이 글의 주제인 지식 증류(Knowledge Distillation, KD)입니다.
KD의 핵심: 정답이 아니라 “헷갈림"을 가르친다
누가 처음 제안했나
큰 모델의 지식을 작은 모델로 옮긴다는 아이디어는 2000년대 중반부터 있었습니다. 이를 “지식 증류(distillation)”라는 이름으로 정리하고 temperature 같은 지금의 틀을 만든 건 제프리 힌튼입니다(Hinton, Vinyals, Dean, 2015). 딥러닝의 대부로 불리며 2018년 튜링상과 2024년 노벨 물리학상을 받은 바로 그 Geoffrey Hinton이 맞습니다. KD의 출발점으로는 보통 이 논문을 인용합니다.
Dark knowledge: 확률에 숨은 정보
고양이 사진 한 장을 봅시다. 정답 라벨(hard label)은 cat = 1, dog = 0입니다. 그런데 잘 학습된 큰 모델(teacher)의 logit이 cat 5, dog 1이라면, softmax 확률은 대략 cat 0.982, dog 0.018입니다.
이 0.018에는 정보가 있습니다. “이 고양이는 개와 약간 닮았다"는 클래스 간 유사도입니다. Hinton은 이것을 dark knowledge라고 불렀습니다. KD는 student가 hard label 대신, 또는 그것과 함께 teacher의 확률 분포를 따라 하도록 학습시킵니다.
Temperature: 숨은 정보를 드러내는 손잡이
그런데 0.982 대 0.018처럼 한쪽으로 쏠린 분포는 hard label과 거의 다를 바 없습니다. 그래서 softmax에 temperature $T$를 넣습니다.
$$p(z_i, T) = \frac{\exp(z_i / T)}{\sum_j \exp(z_j / T)}$$같은 logit(cat 5, dog 1)에서 $T$만 바꾸면 확률이 어떻게 달라지는지, 슬라이더를 직접 움직여 확인해 보세요.
$T$를 키울수록 분포가 부드러워지고, 작은 확률에 숨어 있던 관계 정보가 loss에 의미 있게 반영됩니다. 학습할 때만 $T > 1$을 쓰고, 추론은 $T = 1$로 합니다.
Loss의 모양
가장 기본적인 KD는 두 loss를 섞습니다.
$$\mathcal{L} = (1-\alpha)\,\mathcal{L}_{CE}(y, p_s) + \alpha\, T^2 \cdot \mathrm{KL}\big(p_t^{(T)} \,\|\, p_s^{(T)}\big)$$- 앞쪽은 평범한 분류 loss(정답 라벨)입니다.
- 뒤쪽이 distillation loss로, teacher와 student의 부드러워진 분포를 맞춥니다. cross entropy $-p_t \log p_s$ 형태를 쓰기도 하고, L2 $\|p_t - p_s\|^2$로 맞추기도 합니다.
- $T^2$를 곱하는 이유는 $T$로 나누면 gradient 크기가 $1/T^2$로 줄어들기 때문입니다. 이를 보정해서 $T$를 바꿔도 두 loss의 비중이 유지되게 합니다.
무엇을 따라 하게 할 것인가
출력 확률만 맞출 필요는 없습니다. teacher의 여러 부분을 매칭 대상으로 삼을 수 있는데, 무엇을 전달하느냐로 묶으면 출력, 표현, 관계의 세 갈래입니다.
아래 그림들은 Song Han, MIT 6.5940 EfficientML.ai Lecture 9 슬라이드에서 인용했습니다. 논문 그림을 옮긴 슬라이드는 원 논문도 함께 표기합니다.
출력: 최종 예측을 따라 하기
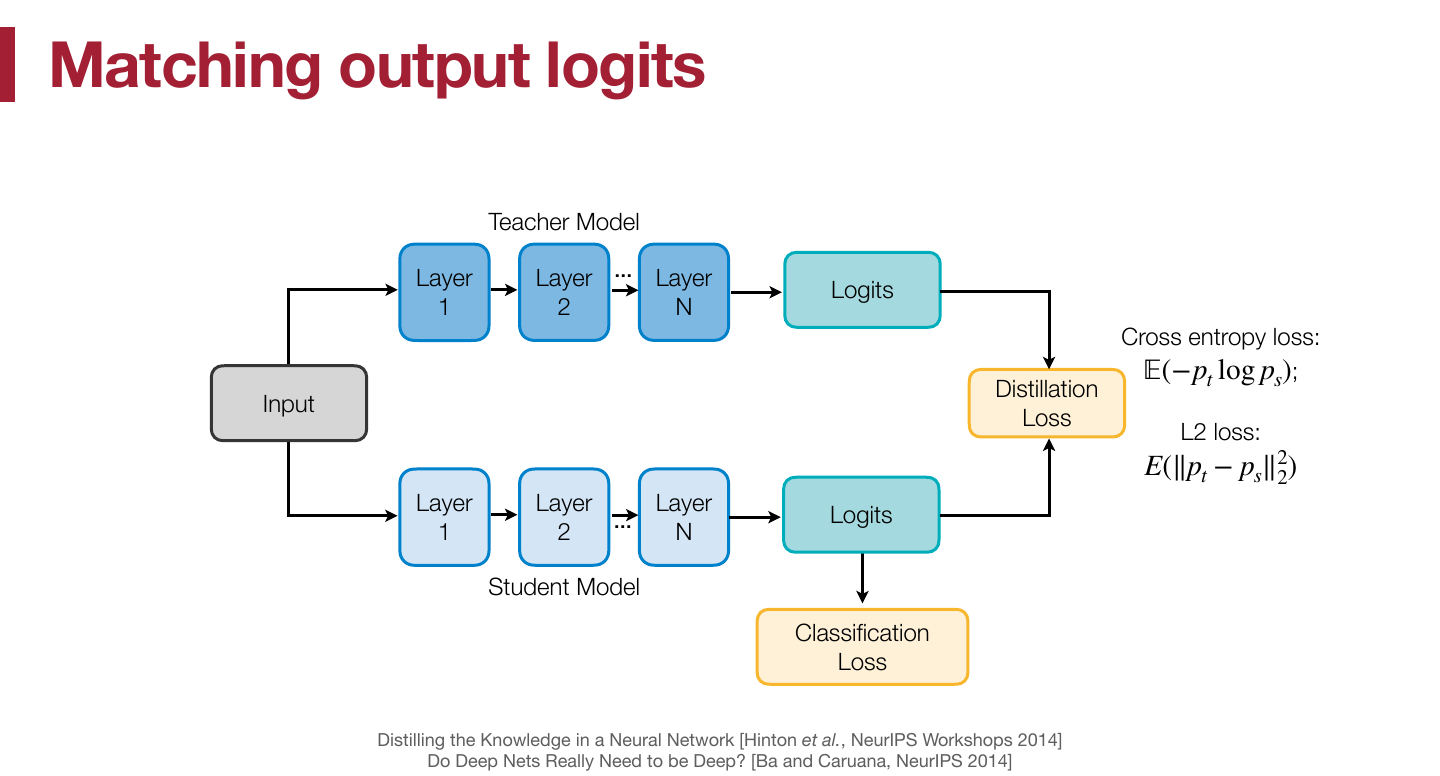
앞에서 본 기본 KD가 여기에 해당합니다. teacher와 student에 같은 입력을 넣고, 마지막 출력(logit)끼리 distillation loss를 겁니다. student는 이와 함께 원래 정답 라벨에 대한 classification loss도 받습니다.
가장 단순하고, teacher와 student의 구조가 완전히 달라도 출력 클래스만 같으면 쓸 수 있다는 게 장점입니다. 대신 teacher가 중간에 어떻게 생각했는지는 전달되지 않습니다.
요즘 오픈 LLM의 소형 라인업도 이 방식을 씁니다. Qwen3의 0.6B–14B 모델은 큰 Qwen3 모델을 teacher로 삼아 logit의 KL divergence를 맞추는 단계를 거쳤고(Qwen3 Technical Report), Gemma 3는 모든 크기를 사전학습 단계부터 teacher의 확률 분포를 따라 하도록 증류해서 학습했습니다.
표현: 중간 과정을 따라 하기
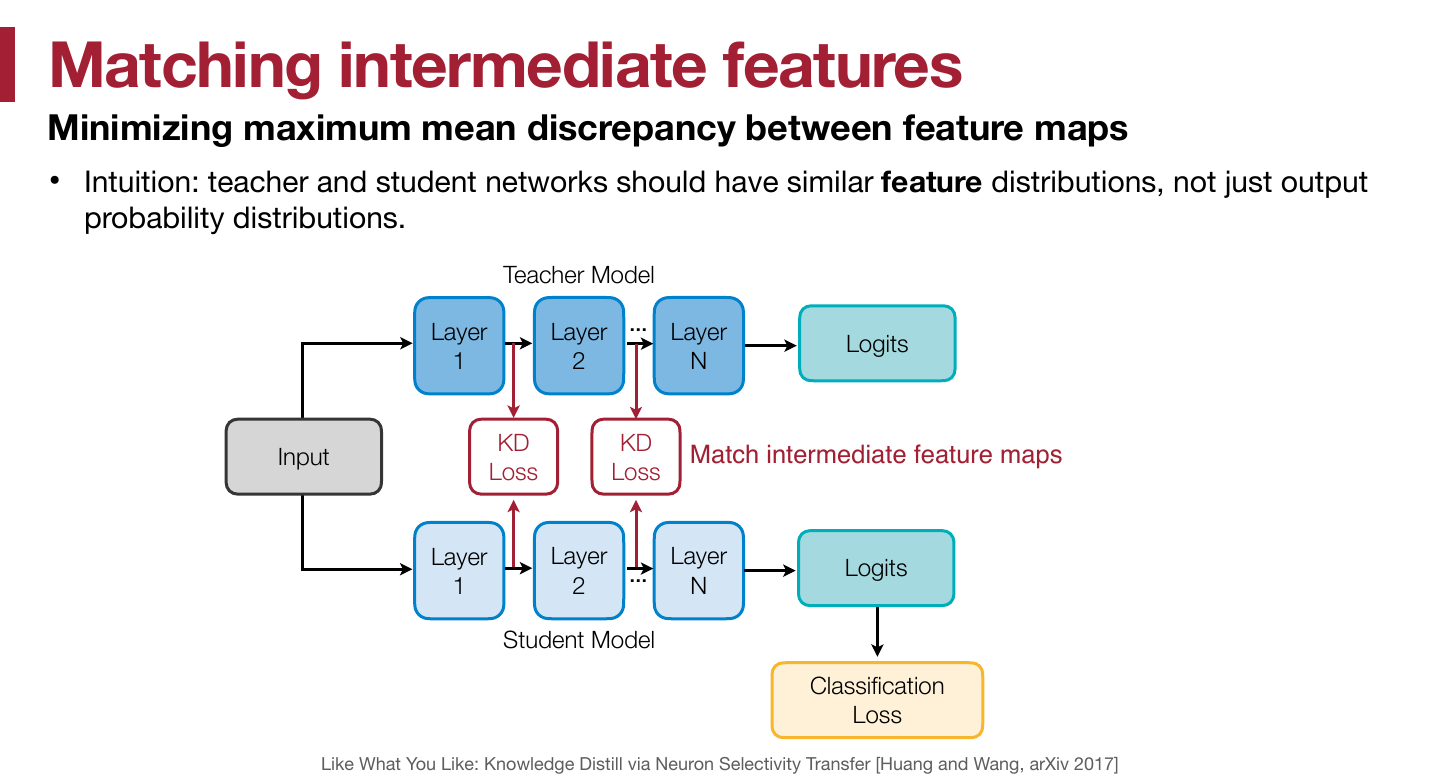
출력만이 아니라 중간 레이어의 표현까지 맞추는 방식입니다. 그림처럼 teacher와 student의 대응하는 레이어 사이마다 KD loss를 겁니다. 직관은 단순합니다. 좋은 student라면 최종 답뿐 아니라 그 답에 이르는 과정(feature의 분포)도 teacher와 비슷해야 한다는 것입니다.
무엇을 “표현"으로 볼지에 따라 여러 변형이 있습니다.
- Feature map 자체 (FitNets 등): 중간 feature를 직접 맞춥니다. student가 더 얇아서 차원이 다르면 linear projection을 하나 끼워 맞춥니다. 값을 하나하나 맞추는 대신 feature 분포 간 거리(MMD)를 줄이기도 합니다.
- Attention map (Attention Transfer): 모델이 입력의 어디를 보는지를 맞춥니다.
- Sparsity pattern: ReLU 뒤에서 어떤 뉴런이 켜지는지 $\rho(x) = \mathbb{1}[x > 0]$를 맞춥니다.
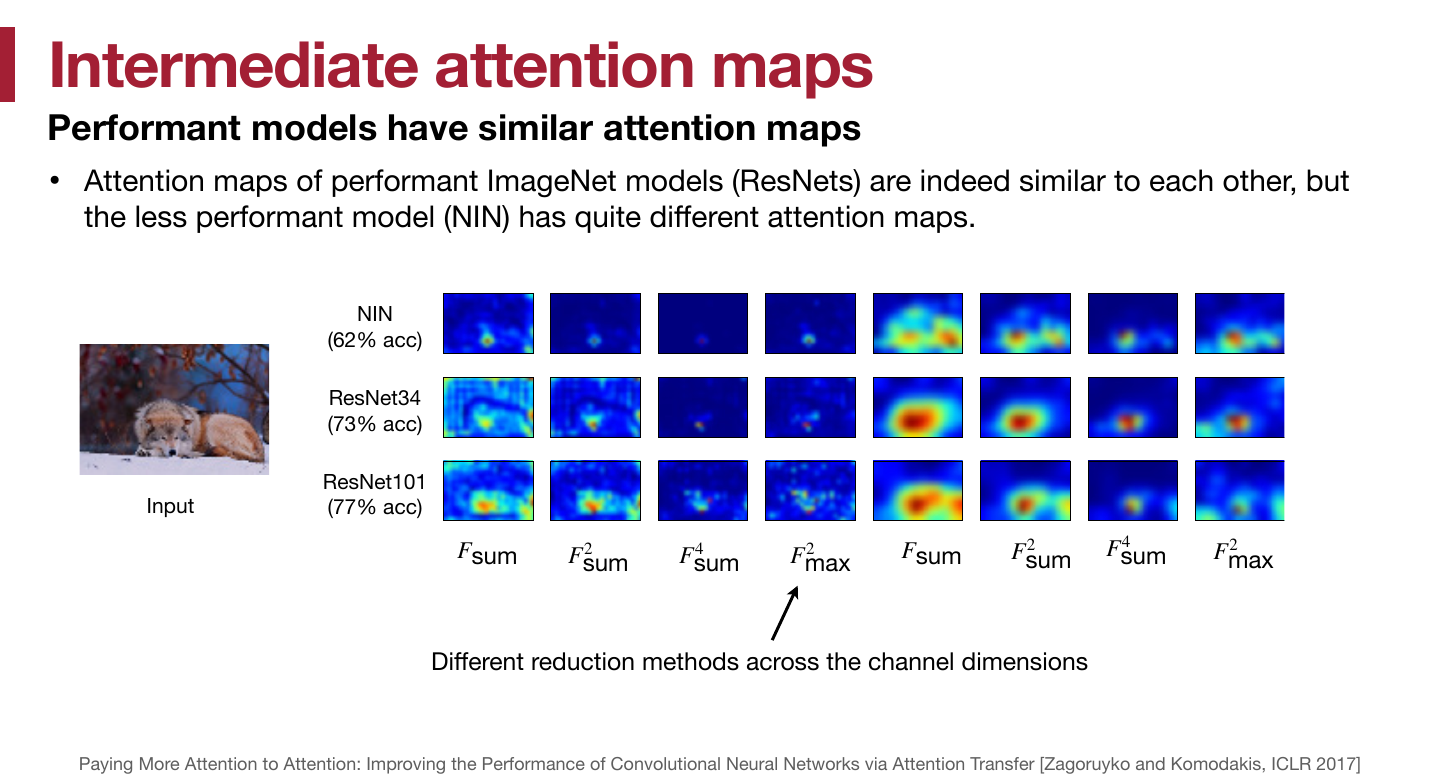
그림 원 출처: Zagoruyko & Komodakis, Paying More Attention to Attention, ICLR 2017
attention을 맞추는 근거가 이 그림입니다. 같은 이미지를 넣었을 때 성능 좋은 ResNet34(73%)와 ResNet101(77%)의 attention map은 서로 닮았지만, 성능이 낮은 NIN(62%)은 전혀 다른 곳을 봅니다. “잘하는 모델은 비슷한 곳을 본다"면, student에게 teacher가 보는 곳을 보도록 가르치는 것이 도움이 됩니다.
표현 매칭은 출력보다 많은 정보를 주지만, 대응하는 레이어를 짝지어야 하므로 teacher와 student의 구조가 비슷할수록 쓰기 편합니다.
관계: 값이 아니라 구조를 따라 하기
출력이든 표현이든 앞의 방식은 값 자체를 맞춥니다. 관계 매칭은 한 걸음 물러서서, 값들 사이의 관계를 맞춥니다. 크게 두 가지가 있습니다.
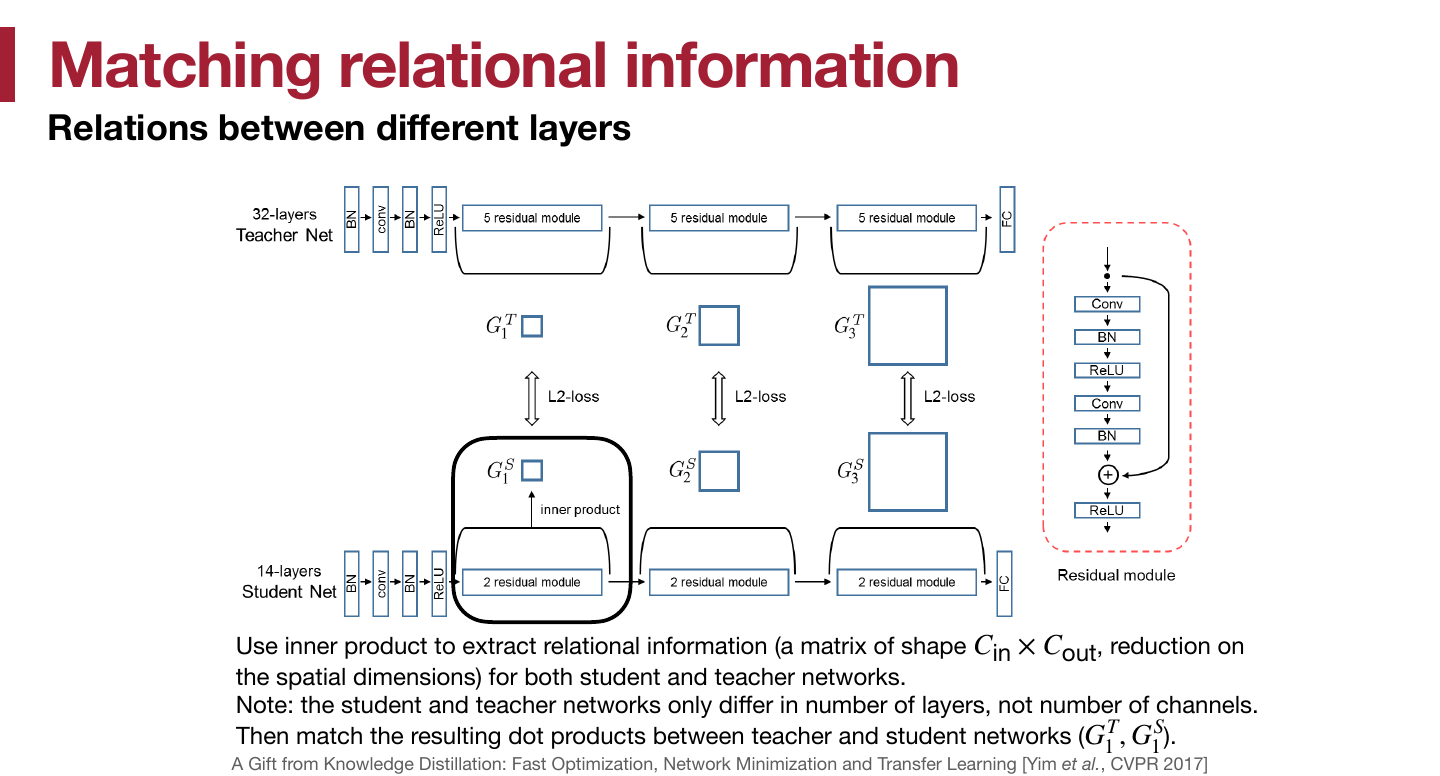
그림 원 출처: Yim et al., A Gift from Knowledge Distillation, CVPR 2017
레이어 사이의 관계 (Yim et al., CVPR 2017): 한 레이어의 입력과 출력 feature를 inner product로 묶어 “이 구간이 정보를 어떻게 변환하는가"를 행렬 하나로 요약합니다. teacher와 student의 이 행렬을 맞춥니다. 그림에서 teacher는 32층, student는 14층으로 깊이가 달라도 됩니다(채널 수는 같아야 합니다).
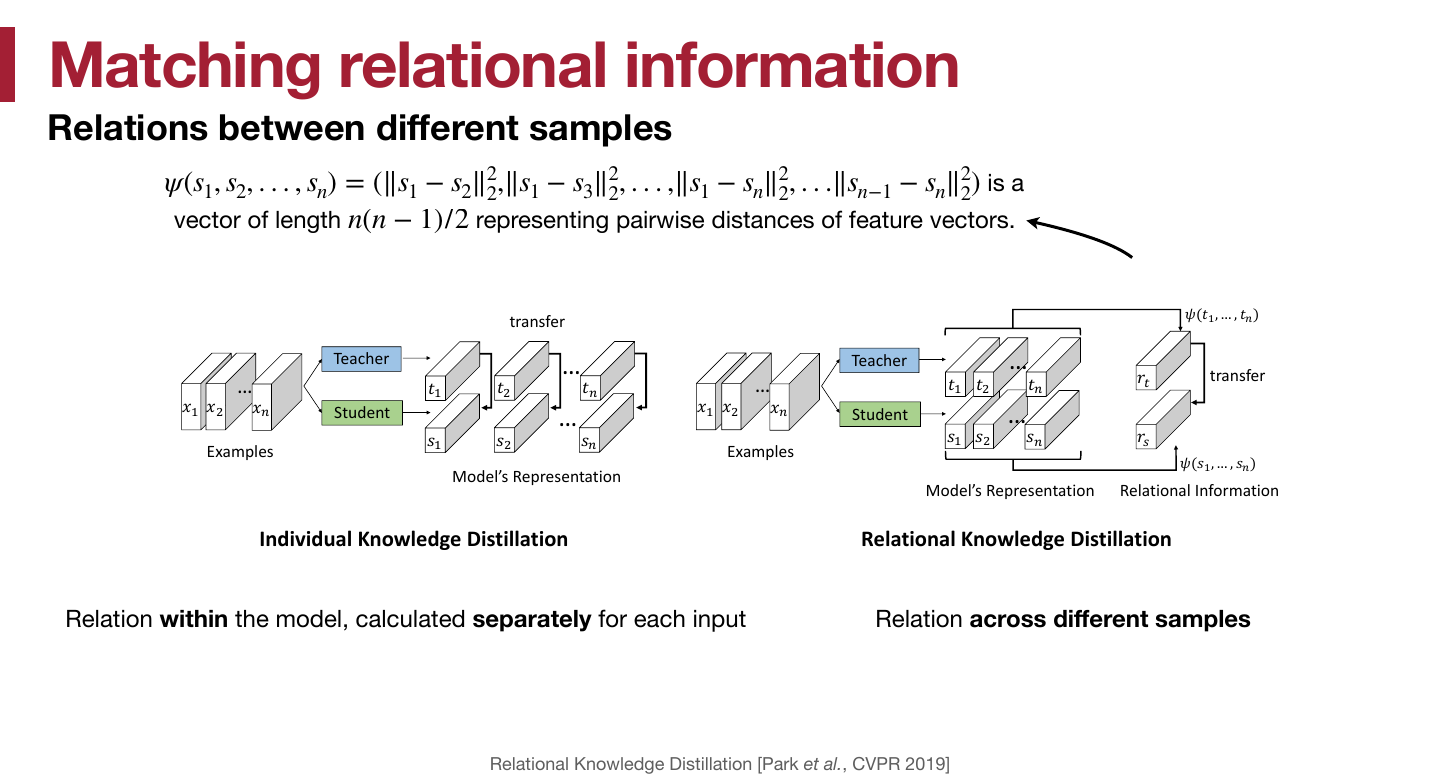
그림 원 출처: Park et al., Relational Knowledge Distillation, CVPR 2019
샘플 사이의 관계 (Relational KD, Park et al., CVPR 2019): 그림 왼쪽의 일반 KD는 샘플마다 따로 teacher 표현 $t_i$를 student 표현 $s_i$로 옮깁니다. 오른쪽의 Relational KD는 샘플 $n$개의 표현 사이 거리 구조 전체를 옮깁니다.
$$\psi(s_1, \ldots, s_n) = \left(\|s_1 - s_2\|_2^2,\ \|s_1 - s_3\|_2^2,\ \ldots,\ \|s_{n-1} - s_n\|_2^2\right)$$$\psi(t_1, \ldots, t_n)$와 $\psi(s_1, \ldots, s_n)$를 맞추면, student는 개별 벡터의 값은 자유롭게 두되 “누가 누구와 가까운가"는 teacher와 같게 학습합니다. 표현의 차원이 달라도 거리만 비교하므로 바로 쓸 수 있습니다.
정리하면
| 묶음 | 무엇을 맞추나 | 구조 제약 | 잘 맞는 곳 |
|---|---|---|---|
| 출력 | 최종 확률 분포 | 거의 없음 | 분류, 판정 모델 |
| 표현 | 중간 feature, attention, 활성 패턴 | teacher와 student 구조가 비슷해야 편함 | 같은 계열 모델을 줄일 때 |
| 관계 | 레이어 간, 샘플 간 관계 | 적음 | 임베딩, 검색 |
임베딩 모델을 distill할 때 관계 매칭이 특히 잘 맞는 이유도 여기 있습니다. 임베딩은 벡터의 절대값보다 “누가 누구와 가까운가"가 중요하기 때문입니다.
LLM 시대의 KD
KD는 detection, segmentation, GAN, BERT(MobileBERT) 등 여러 태스크에 쓰여 왔지만, 요즘 가장 중요한 건 LLM 쪽입니다. pruning과 distillation의 조합이 작은 LLM을 만드는 표준 공정이 됐습니다.
- Minitron (NVIDIA, NeurIPS 2024): 큰 모델에서 head, channel, embedding 차원을 잘라낸 뒤(프루닝 #3), 원본 모델을 teacher로 삼아 KD로 성능을 복원합니다. 처음부터 학습하는 것보다 학습 토큰을 수십 배 적게 씁니다.
- Llama 3.2 1B/3B: 8B를 pruning한 뒤 8B와 70B의 logit을 학습 신호로 써서 만든 경량 모델입니다. 앞서 본 Qwen3, Gemma 3와 같은 흐름입니다.
LLM에서 KD는 크게 두 방식으로 씁니다.
| 방식 | 하는 일 | 장단점 |
|---|---|---|
| Sequence-level KD | teacher가 생성한 응답으로 student를 SFT | 간단하고 API 모델도 teacher로 쓸 수 있음. 분포 정보는 사라짐 |
| Logit-level KD | 토큰마다 teacher의 확률 분포(보통 top-k)를 KL로 맞춤 | 말투나 어휘 선택까지 더 잘 옮겨짐. teacher logit에 접근할 수 있어야 함 |
생성 대신 판정: Jev와 RLCD, 그리고 Hinton의 문제의식
LLM이 응답을 생성하는 대신 판정만 내리게 하면, 작은 모델로도 충분합니다. 여기서는 그 판정 모델의 대표 격인 Jev가 확률을 어떻게 다루는지, 그리고 그것이 KD의 출발점과 어떻게 맞닿는지 봅니다.
RLCD: 확률이 맞아야 한다
배경에서 소개한 Jev는 판정과 함께 calibrated 확률을 돌려준다는 점을 내세웁니다. TypeSafe는 이를 위해 Jev를 RLCD(Reinforcement Learning for Calibrated Decisions)로 학습했다고 밝혔습니다. RLHF와 대비해 보면 의도가 분명합니다.
| RLHF | RLCD | |
|---|---|---|
| 보상의 기준 | 사람이 좋다고 평가한 답변 | 맞는 판정과 실제 정답률에 맞는 확신도 |
| 결과물 | 그럴듯하고 선호되는 문장 | 판정과 믿을 수 있는 확률 |
핵심 단어는 calibration입니다. 모델이 “90% 확신"이라고 답한 판정들을 모아 보면 실제로 90%가 맞아야 한다는 뜻입니다. TypeSafe의 논리는 이렇습니다. 모델이 95%를 맞히더라도 틀리는 5%가 어느 것인지 스스로 말해 주지 못하면 자동화에 쓸 수 없습니다. 확률을 믿을 수 있어야 “확신 0.95 이상은 자동 처리, 그 아래는 사람이나 큰 모델로"라는 정책을 짤 수 있습니다.
다만 RLCD는 지금까지 TypeSafe의 블로그와 그 보도로만 알려졌습니다. loss 함수나 보상 설계 같은 구체적인 방법은 공개되지 않았으니, “보정된 확률을 목표로 강화학습했다"는 방향성 정도로 받아들이는 게 맞습니다.
Hinton이 먼저 짚었던 것
이 문제의식은 낯설지 않습니다. 앞에서 본 Hinton의 KD가 출발한 지점이 바로 “정답만으로는 정보가 부족하고, 확률값 자체에 정보가 있다”는 것이었습니다. 고양이 사진에 대한 dog 0.018은 버릴 숫자가 아니라 “개와 약간 닮았다"는 지식이었습니다.
두 접근은 같은 질문을 서로 다른 쪽에서 다룹니다.
| Hinton의 KD | RLCD | |
|---|---|---|
| 확률을 보는 관점 | 확률에 지식이 담겨 있다 | 확률이 신뢰도로서 정확해야 한다 |
| 확률의 쓰임 | student를 가르치는 학습 신호 | 사용자가 판단을 맡길지 정하는 운영 신호 |
| 핵심 도구 | temperature로 숨은 확률을 드러냄 | 강화학습으로 확률을 실제 정답률에 맞춤 |
KD는 teacher의 확률을 옮기는 방법이고, RLCD는 그 확률을 믿을 수 있게 만드는 방법입니다. 둘 다 “답 하나보다 확률 분포가 중요하다"는 전제를 공유합니다. 그리고 이 둘은 서로를 보완합니다. teacher의 확률이 잘 보정되어 있을수록, 그 확률을 따라 하는 student도 믿을 만한 확신도를 물려받습니다. 반대로 과신하는 teacher를 증류하면 과신까지 그대로 옮겨 갑니다.
판정 모델은 어떻게 만들어졌나
Jev 이후 쏟아진 오픈 판정 모델들은 구조가 거의 비슷합니다. ModernBERT 같은 작은 인코더가 상태와 질문을 읽고, 선택지마다 점수를 매겨 확률로 바꿉니다. 차이는 그 확률을 무엇으로 가르치느냐에서 납니다.
| Laya | OpenDecider | |
|---|---|---|
| 확률을 가르치는 방법 | 사람이 라벨링한 데이터로, 확률이 정직할 때 보상 | 큰 LLM의 보정된 확률 분포를 증류 |
| 이 글과의 연결 | RLCD의 오픈 구현 | Hinton식 KD 그대로 |
OpenDecider는 KD가 판정 모델에서 어떻게 쓰이는지 잘 보여줍니다. teacher(Qwen3-235B, DeepSeek)의 확률을 held-out 데이터에서 temperature scaling으로 먼저 보정하고, student는 정답 라벨이 아니라 그 분포를 따라 하도록 학습합니다. 그 결과 Qwen3-4B 기반 student의 보정 오차(ECE)가 0.289에서 0.087로 떨어졌습니다(자체 발표 기준). 앞에서 말한 대로, 보정된 teacher를 증류하면 student도 보정을 물려받는다는 것이 실제로 확인된 셈입니다.
같은 temperature가 Hinton에게는 숨은 지식을 드러내는 손잡이였다면, 여기서는 teacher의 확률을 믿을 수 있게 만드는 보정 도구로 쓰입니다. 판정 모델의 시대에는 이 손잡이가 신뢰도를 다루는 데에도 쓰이고 있습니다.
캐릭터 채팅 서비스에서 어디에 쓰나
캐릭터 채팅은 대화량이 많고, 지연에 민감하며, 품질이 주관적인 서비스입니다. 한 턴을 쪼개 보면 “대사 생성” 한 번 주변에 판정이 여러 번 붙어 있습니다. 안전한가, 어느 모델로 보낼까, 기억할 만한가, 호감도가 변했나. 이 구조는 인코더 전략 글에서 다룬 “생성하지 말고 판단하라"와 같은 이야기입니다.
현실적인 순서는 이렇게 봅니다.
- 판정 레이어 프로토타입: Jev 같은 판정 API로 스키마만 정의해 빠르게 검증합니다.
- 내재화: 트래픽이 커지거나 데이터 반출이 부담되면, 판정 결과와 확률을 teacher 신호로 삼아 자체 인코더로 distill합니다.
- 생성 레이어: 여기는 판정 모델이 대체할 수 없습니다. 고전적인 LLM KD로 student 모델을 만듭니다.
또 다른 접근: 데이터 대신 모델을 증강하는 NetAug
글 앞부분에서 “작은 모델의 문제는 underfit”이라는 NetAug 논문의 진단을 봤습니다. 마지막으로 이 논문이 내놓은 처방을 살펴봅니다. 처방의 방향은 KD와 다릅니다. 정답을 바꾸는 대신, 학습하는 동안만 모델을 키웁니다.
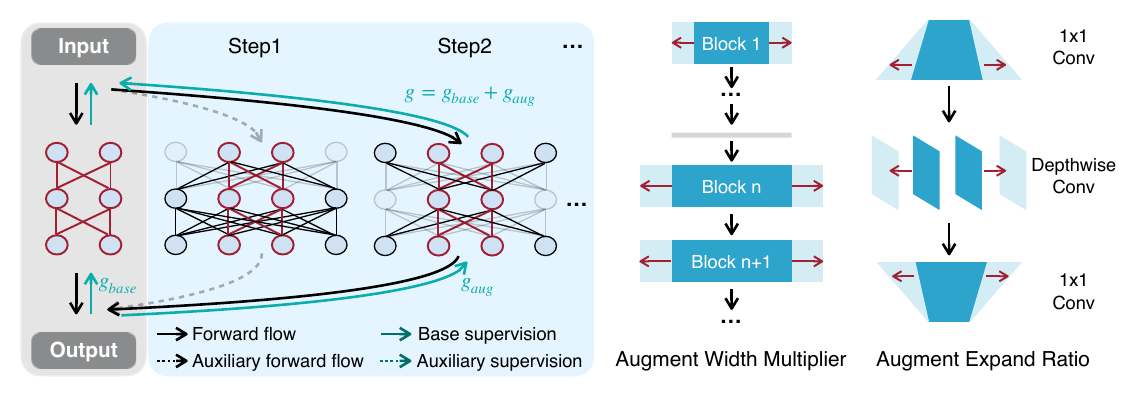
출처: Cai et al., Network Augmentation for Tiny Deep Learning, ICLR 2022, Figure 2
dropout을 뒤집다
dropout은 학습 중에 네트워크 일부를 끕니다. 남은 일부만으로도 예측하도록 만들어서 과적합을 막습니다. NetAug는 정반대로 학습 중에 네트워크를 넓힙니다. 그림 왼쪽에서 빨간색이 원래의 작은 모델이고, 그 바깥으로 채널을 덧붙인 더 넓은 모델들(검은색)이 작은 모델을 품고 있습니다.
작은 모델은 두 가지 역할을 동시에 학습합니다.
- 혼자서 예측하기 (base supervision): 평소처럼 자기 loss로 학습합니다.
- 큰 모델의 부품으로 예측하기 (auxiliary supervision): 넓힌 모델의 일부로서도 좋은 표현을 만들도록 학습합니다.
여기서 $W_t$는 작은 모델의 가중치이고, $[W_t, W_i]$는 작은 모델에 새 가중치 $W_i$를 덧붙인 넓은 모델입니다. 작은 모델의 가중치는 양쪽 loss에서 모두 gradient를 받으므로, 혼자 학습할 때보다 감독 신호가 늘어납니다. 논문은 이것을 용량이 부족한 모델이 local minimum에 갇히지 않도록 돕는 장치로 설명합니다.
학습할 때는 매 스텝 넓은 모델 하나를 골라 보조 신호를 얻고, 학습이 끝나면 덧붙였던 가중치는 버리고 원래의 작은 모델만 배포합니다. 구조가 그대로이므로 추론 비용은 전혀 늘지 않습니다.
결과와 KD와의 관계
- MobileNetV2-Tiny의 ImageNet 정확도가 1.6%p 올랐고, 학습 비용은 16.7% 늘었습니다. Figure 1에서 다른 regularization이 모두 정확도를 떨어뜨린 것과 대조적입니다.
- object detection(YOLOv3)에서는 같은 성능을 38–41% 적은 연산으로 냈습니다.
- KD와 비교하면 NetAug 단독이 조금 더 높았고(+0.4–0.8%p), 둘을 함께 쓸 때 가장 좋았습니다(MobileNetV2-Tiny 기준 +2.7%p).
두 방법이 겹치지 않는 이유는 작동 원리가 다르기 때문입니다. NetAug는 학습 중에 용량을 빌려주고, KD는 더 정보가 많은 정답을 줍니다. 같은 문제(작은 모델의 underfit)를 서로 다른 쪽에서 공략하는 셈입니다.
정리
- 작은 모델의 문제는 대개 과적합이 아니라 용량 부족(underfit)입니다. 그래서 큰 모델용 regularization이 오히려 해롭습니다.
- KD는 정답 라벨 대신 더 정보가 많은 정답(teacher의 확률 분포)을 줘서 이를 보완합니다. temperature $T$는 그 분포에 숨은 클래스 간 관계를 드러내는 손잡이입니다.
- 출력, 중간 표현, 관계 중 무엇을 맞출지는 teacher와 student 구조, 그리고 태스크(분류냐 임베딩이냐)에 따라 고릅니다.
- LLM에서는 pruning + KD가 작은 모델을 만드는 표준 공정이 됐습니다.
- 판정 모델에서는 확률이 지식이자 신뢰도입니다. KD는 teacher의 확률을 옮기고, 보정(calibration)은 그 확률을 믿을 수 있게 만듭니다. 보정된 teacher를 증류하면 student도 보정을 물려받습니다.
- KD와 별개로, 학습 중에만 모델을 넓혀 용량을 빌려주는 NetAug도 있습니다. 둘은 함께 쓸 때 가장 좋습니다.
관련 글
- 경량화 시리즈 #3: 뉴럴넷 프루닝: Minitron의 앞단계.
- 경량화 시리즈 #5, QAT: 학습으로 압축 손실을 되돌리는 또 하나의 방법.
- 생성하지 말고 판단하라: 인코더 전략: 캐릭터 AI에서 판정을 인코더로 내린 실전 기록.
참고
- MIT 6.5940 Lecture 9: Knowledge Distillation (Song Han)
- Hinton et al., Distilling the Knowledge in a Neural Network, NeurIPS Workshop 2014 (arXiv 2015)
- Romero et al., FitNets: Hints for Thin Deep Nets, ICLR 2015
- Zagoruyko & Komodakis, Paying More Attention to Attention, ICLR 2017
- Yim et al., A Gift from Knowledge Distillation, CVPR 2017
- Park et al., Relational Knowledge Distillation, CVPR 2019
- Muralidharan et al., Compact Language Models via Pruning and Knowledge Distillation (Minitron), NeurIPS 2024
- Qwen Team, Qwen3 Technical Report, 2025
- Gemma Team, Gemma 3 Technical Report, 2025
- Meta, Llama 3.2: Revolutionizing edge AI and vision with open, customizable models, 2024
- Cai et al., Network Augmentation for Tiny Deep Learning, ICLR 2022
- TypeSafe AI, Introducing System One Models & Jev
- One Week of System One Models: From Jev to Your Own Environment
- OpenDecider: Open, Calibrated Decision Models
- Laya (Convai Innovations)
- Open-source Jev alternatives: System One models you can self-host